


Индекс в SQL — это отдельная структура данных, которая хранит значения одного или нескольких столбцов таблицы в отсортированном виде вместе со ссылками на нужные строки, чтобы база данных могла находить строки быстро, не просматривая всю таблицу целиком. Без индекса поиск по условию WHERE email = 'user@example.com' означает full table scan — база проверяет каждую строку таблицы по очереди. С индексом по столбцу email база находит нужное значение почти мгновенно, как поиск слова в отсортированном алфавитном справочнике, а не пролистывание книги страница за страницей.
Аналогия: индекс в книге
CREATE INDEX idx_users_email ON users (email);
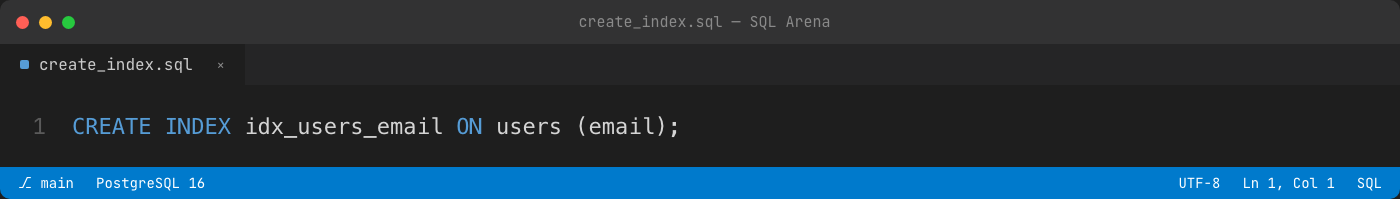
Индекс в базе данных работает похоже на предметный указатель в конце учебника: вместо того чтобы листать все 400 страниц в поисках упоминания конкретного термина, можно посмотреть в алфавитный список в конце книги и сразу перейти на нужную страницу. Индекс idx_users_email делает то же самое для столбца email таблицы users — база хранит отсортированные значения email вместе с указателями на физическое расположение строк, и поиск конкретного значения происходит через быстрый алгоритм поиска по отсортированной структуре (обычно B-дерево), а не последовательным перебором.
Почему индексы не ставят на все столбцы подряд
Индекс ускоряет чтение (SELECT), но замедляет запись (INSERT, UPDATE, DELETE) — при каждом изменении данных в проиндексированном столбце базе нужно обновить не только саму таблицу, но и структуру индекса. Кроме того, каждый индекс занимает дополнительное место на диске — для больших таблиц это заметный объём. Индекс имеет смысл там, где столбец часто используется в условиях WHERE, в JOIN, или в ORDER BY, и где стоимость лишнего места и замедления записи оправдана выигрышем в скорости чтения. Индексировать столбец, который редко участвует в поиске, или таблицу, в которую пишут гораздо чаще, чем читают — обычно не стоит.
Потренируйтесь на задачах
В SQL Arena больше тысячи задач с автопроверкой на настоящих таблицах: от первого SELECT до оконных функций и задач с собеседований. Задачи уровня Easy бесплатны, регистрация без карты.
Открыть SQL ArenaСоставной индекс и порядок столбцов
CREATE INDEX idx_orders_user_date ON orders (user_id, created_at);
-- этот запрос использует индекс эффективно:
SELECT * FROM orders WHERE user_id = 42 AND created_at > '2026-01-01';
-- а этот — не использует индекс так же эффективно:
SELECT * FROM orders WHERE created_at > '2026-01-01';
-- этот запрос использует индекс эффективно:
SELECT * FROM orders WHERE user_id = 42 AND created_at > '2026-01-01';
-- а этот — не использует индекс так же эффективно:
SELECT * FROM orders WHERE created_at > '2026-01-01';
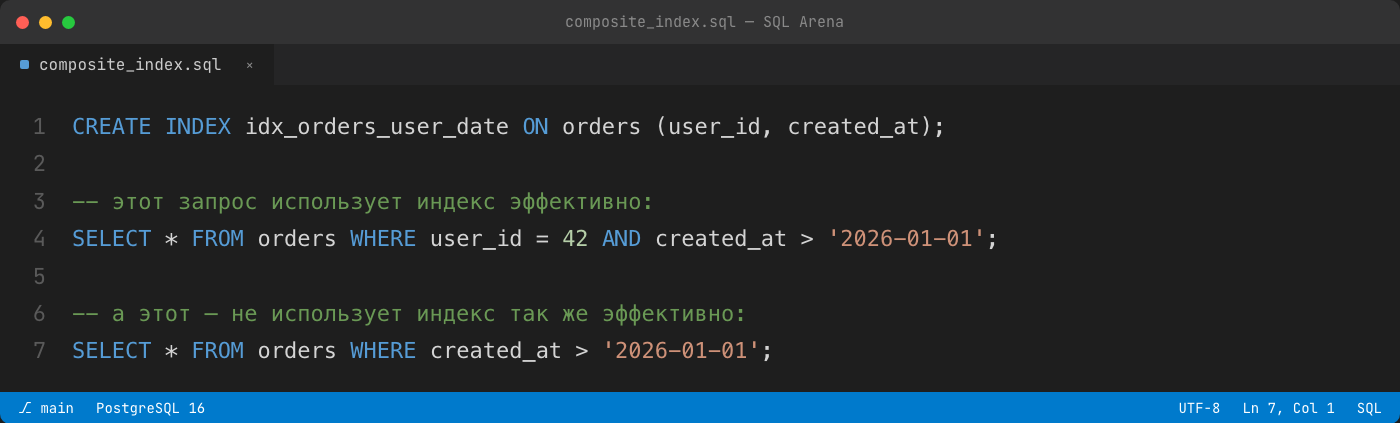
Составной индекс по нескольким столбцам работает как телефонная книга, отсортированная сначала по фамилии, потом по имени: поиск по фамилии (или по фамилии и имени вместе) быстрый, а поиск только по имени, без фамилии, всю сортировку не использует. idx_orders_user_date эффективен для запросов, где user_id указан в условии — сначала база находит нужный user_id, а затем внутри него быстро ищет по created_at. Запрос только по created_at, без user_id, этот индекс использовать эффективно не может, потому что данные отсортированы в первую очередь по user_id, а не по дате.
EXPLAIN — как узнать, использует ли запрос индекс
EXPLAIN SELECT * FROM users WHERE email = 'user@example.com';
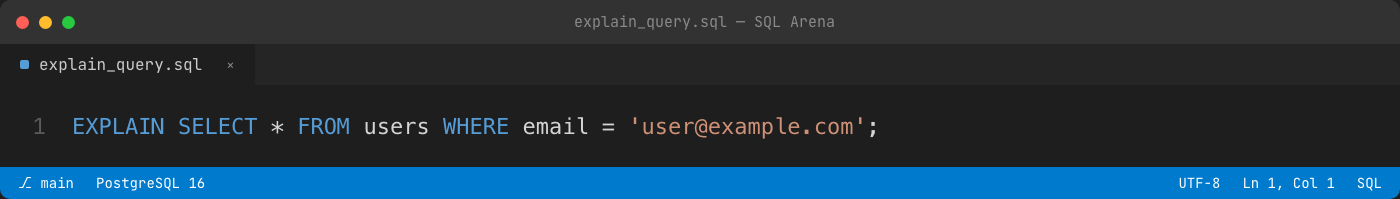
EXPLAIN показывает план выполнения запроса, не выполняя его. EXPLAIN ANALYZE (доступно в PostgreSQL) даёт более подробный вывод с реальным временем выполнения — но при этом сам запрос реально выполняется, а не просто анализируется на бумаге. На SELECT это безопасно, а вот на UPDATE, DELETE или INSERT — нет: EXPLAIN ANALYZE в этом случае реально изменит данные, поэтому на таких запросах его стоит запускать либо в транзакции с последующим ROLLBACK, либо вообще ограничиться обычным EXPLAIN без ANALYZE. — как именно база собирается получить данные. В выводе видно, использует ли запрос индекс (Index Scan) или читает всю таблицу целиком (Seq Scan в PostgreSQL, ALL в MySQL). Это единственный надёжный способ проверить, действительно ли добавленный индекс работает для конкретного запроса — угадывать по интуиции здесь не стоит, оптимизатор запросов иногда решает не использовать индекс, даже если он есть, если посчитает full scan более выгодным для конкретных данных.
Частые вопросы про индексы в SQL
Индекс всегда ускоряет запросы? Нет. Индекс ускоряет чтение по условиям, которые он покрывает, но замедляет запись и занимает место на диске. Для маленьких таблиц или столбцов, которые редко участвуют в поиске, индекс может быть бесполезен или даже вреден.
Почему запрос не использует индекс, хотя он создан? Причины разные: несовпадение типов данных в условии, использование функции над индексируемым столбцом (WHERE LOWER(email) = ... не использует обычный индекс по email), оптимизатор посчитал full scan более выгодным для маленькой таблицы, или составной индекс используется не с первым столбцом в условии. Проверить реальную причину можно через EXPLAIN.
В чём разница между обычным индексом и уникальным (UNIQUE)? Обычный индекс просто ускоряет поиск. UNIQUE-индекс дополнительно гарантирует, что все значения в столбце уникальны — попытка вставить дубликат вызовет ошибку. Первичный ключ (PRIMARY KEY) автоматически создаёт уникальный индекс.
Нужно ли индексировать внешние ключи (foreign key)? В большинстве СУБД (например, PostgreSQL) индекс на внешний ключ не создаётся автоматически, хотя запросы с JOIN по нему выполняются часто — стоит добавлять индекс на внешние ключи вручную, если таблица большая и по ней часто делают JOIN или удаление связанных записей. Подробнее о соединениях — в статье «JOIN в SQL: разбор всех типов соединений на примерах».
Почему запрос не использует индекс, хотя он создан? Причины разные: несовпадение типов данных в условии, использование функции над индексируемым столбцом (WHERE LOWER(email) = ... не использует обычный индекс по email), оптимизатор посчитал full scan более выгодным для маленькой таблицы, или составной индекс используется не с первым столбцом в условии. Проверить реальную причину можно через EXPLAIN.
В чём разница между обычным индексом и уникальным (UNIQUE)? Обычный индекс просто ускоряет поиск. UNIQUE-индекс дополнительно гарантирует, что все значения в столбце уникальны — попытка вставить дубликат вызовет ошибку. Первичный ключ (PRIMARY KEY) автоматически создаёт уникальный индекс.
Нужно ли индексировать внешние ключи (foreign key)? В большинстве СУБД (например, PostgreSQL) индекс на внешний ключ не создаётся автоматически, хотя запросы с JOIN по нему выполняются часто — стоит добавлять индекс на внешние ключи вручную, если таблица большая и по ней часто делают JOIN или удаление связанных записей. Подробнее о соединениях — в статье «JOIN в SQL: разбор всех типов соединений на примерах».
Закрепить работу с индексами на практике
Увидеть своими глазами, как EXPLAIN показывает использование индекса (или его отсутствие), проще на реальных запросах. Потренироваться можно на тренажёре SQL Arena от Quality Academy — 1 192 задачи с автопроверкой, все задачи уровня Easy бесплатны.
Потренируйтесь на задачах
В SQL Arena больше тысячи задач с автопроверкой на настоящих таблицах: от первого SELECT до оконных функций и задач с собеседований. Задачи уровня Easy бесплатны, регистрация без карты.
Открыть SQL ArenaКурс «Инженер по ручному тестированию»
Учим с нуля до трудоустройства: персональный ментор, задания в Jira, подготовка к собеседованиям и поддержка на испытательном сроке.
Узнать о курсеQuality Academy — школа тестировщиков


