Это вторая часть серии «SQL с нуля». В первой части разобрали SELECT, WHERE, ORDER BY, LIMIT, JOIN и GROUP BY. Если эти команды пока не уверенно — начните оттуда, здесь мы отталкиваемся от них.
Агрегатные функции и подзапросы — следующий логичный шаг после базовых выборок. Агрегаты позволяют считать итоги (сколько, сколько всего, сколько в среднем), а подзапросы — использовать результат одного запроса внутри другого. Вместе они закрывают большую часть задач среднего уровня сложности, которые встречаются и в реальной работе, и на собеседованиях.
Работаем на тех же таблицах, что и в первой части: customers (клиенты) и orders (заказы), где orders.customer_id ссылается на customers.id.
Агрегатные функции и подзапросы — следующий логичный шаг после базовых выборок. Агрегаты позволяют считать итоги (сколько, сколько всего, сколько в среднем), а подзапросы — использовать результат одного запроса внутри другого. Вместе они закрывают большую часть задач среднего уровня сложности, которые встречаются и в реальной работе, и на собеседованиях.
Работаем на тех же таблицах, что и в первой части: customers (клиенты) и orders (заказы), где orders.customer_id ссылается на customers.id.
Агрегатные функции: COUNT, SUM, AVG, MIN, MAX
Агрегатная функция превращает набор строк в одно число. Пять базовых агрегатов:
— `COUNT()` — считает количество строк.
— `SUM()` — считает сумму числовой колонки.
— `AVG()` — считает среднее значение.
— `MIN()` / `MAX()` — находят минимальное и максимальное значение.
SELECT
COUNT(*) AS total_orders,
SUM(amount) AS total_revenue,
AVG(amount) AS avg_order,
MIN(amount) AS min_order,
MAX(amount) AS max_order
FROM orders;
— `COUNT()` — считает количество строк.
— `SUM()` — считает сумму числовой колонки.
— `AVG()` — считает среднее значение.
— `MIN()` / `MAX()` — находят минимальное и максимальное значение.
SELECT
COUNT(*) AS total_orders,
SUM(amount) AS total_revenue,
AVG(amount) AS avg_order,
MIN(amount) AS min_order,
MAX(amount) AS max_order
FROM orders;
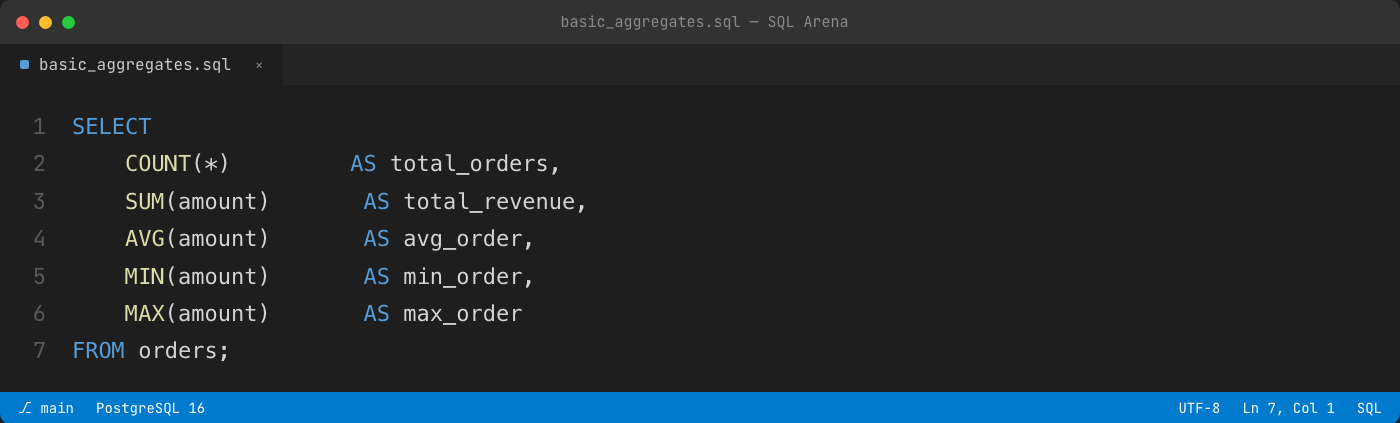
Один запрос сразу даёт: сколько всего заказов, на какую сумму, средний чек, минимальный и максимальный заказ. Без GROUP BY агрегат считается по всей таблице целиком, результат — одна строка.
COUNT(*) и COUNT(column) — не одно и то же
Частая путаница новичков: COUNT(*) считает все строки, включая те, где в интересующей колонке NULL. COUNT(column) считает только строки, где значение этой колонки не `NULL`.
SELECT
COUNT(*) AS all_customers,
COUNT(phone) AS with_phone
FROM customers;
COUNT(*) и COUNT(column) — не одно и то же
Частая путаница новичков: COUNT(*) считает все строки, включая те, где в интересующей колонке NULL. COUNT(column) считает только строки, где значение этой колонки не `NULL`.
SELECT
COUNT(*) AS all_customers,
COUNT(phone) AS with_phone
FROM customers;
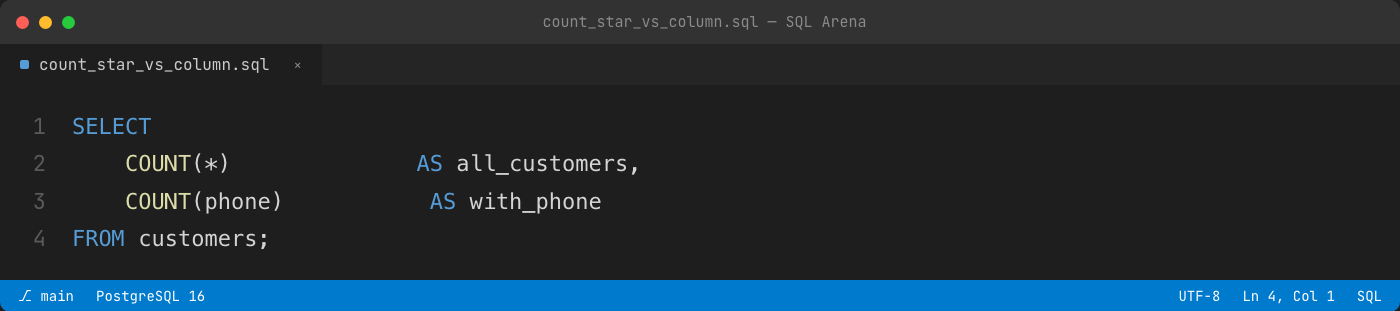
Если у части клиентов телефон не указан (phone IS NULL), COUNT(*) и COUNT(phone) дадут разные числа. Разница между ними — это ровно количество клиентов без телефона.
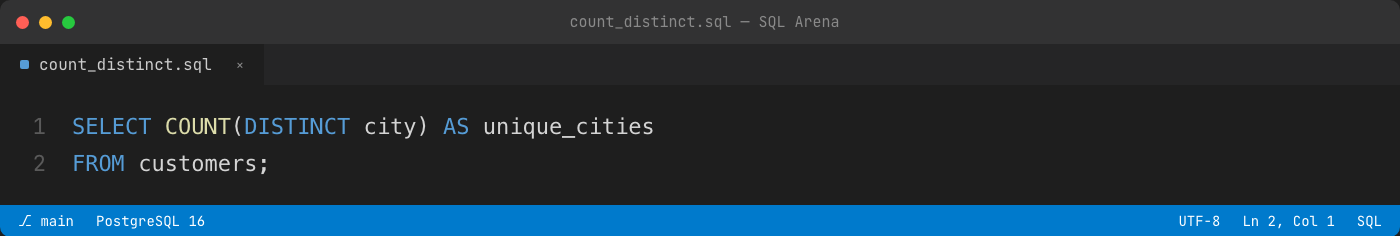
COUNT(DISTINCT column) считает количество уникальных значений — например, сколько разных городов встречается среди клиентов:
SELECT COUNT(DISTINCT city) AS unique_cities
FROM customers;
COUNT(DISTINCT column) считает количество уникальных значений — например, сколько разных городов встречается среди клиентов:
SELECT COUNT(DISTINCT city) AS unique_cities
FROM customers;
Агрегаты в связке с GROUP BY
По-настоящему агрегаты раскрываются вместе с GROUP BY — тогда считаются не одна итоговая цифра, а итог по каждой группе.
SELECT
city,
COUNT(*) AS customers_count,
AVG(age) AS avg_age
FROM customers
GROUP BY city;
SELECT
city,
COUNT(*) AS customers_count,
AVG(age) AS avg_age
FROM customers
GROUP BY city;
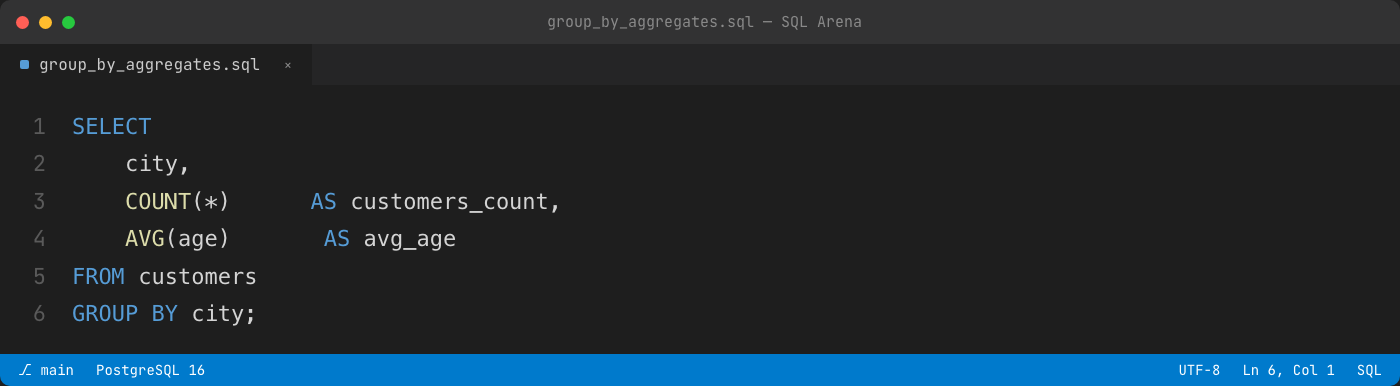
Для каждого города — своё количество клиентов и свой средний возраст. Это основа практически любого аналитического отчёта: «продажи по месяцам», «средний чек по регионам», «количество заказов по статусам».
Подзапросы: запрос внутри запроса
Подзапрос (subquery) — это SELECT, вложенный внутрь другого запроса. Он выполняется первым, а его результат используется во внешнем запросе.
Подзапрос в WHERE
Самое частое применение — сравнить строку с результатом отдельного вычисления.
-- Клиенты, чей средний заказ выше общего среднего по всем заказам
SELECT DISTINCT c.name
FROM customers c
JOIN orders o ON c.id = o.customer_id
WHERE o.amount > (
SELECT AVG(amount) FROM orders
);
Подзапрос в WHERE
Самое частое применение — сравнить строку с результатом отдельного вычисления.
-- Клиенты, чей средний заказ выше общего среднего по всем заказам
SELECT DISTINCT c.name
FROM customers c
JOIN orders o ON c.id = o.customer_id
WHERE o.amount > (
SELECT AVG(amount) FROM orders
);
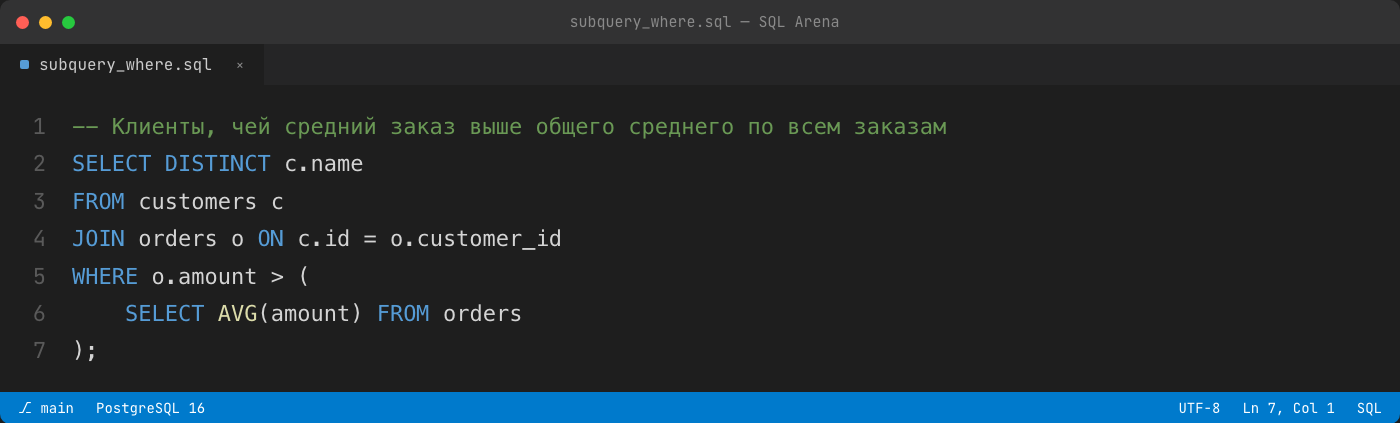
Подзапрос (SELECT AVG(amount) FROM orders) вычисляется один раз и возвращает одно число — общую среднюю сумму заказа. Внешний запрос сравнивает с ним каждую строку. Такой подзапрос называется скалярным — он возвращает ровно одно значение, поэтому его можно использовать там, где ожидается число: после =, >, < и подобных операторов.
Подзапрос с IN
Когда подзапрос возвращает не одно значение, а список, используется IN:
-- Клиенты, у которых есть хотя бы один заказ дороже 3000
SELECT name
FROM customers
WHERE id IN (
SELECT customer_id FROM orders WHERE amount > 3000
);
Подзапрос с IN
Когда подзапрос возвращает не одно значение, а список, используется IN:
-- Клиенты, у которых есть хотя бы один заказ дороже 3000
SELECT name
FROM customers
WHERE id IN (
SELECT customer_id FROM orders WHERE amount > 3000
);
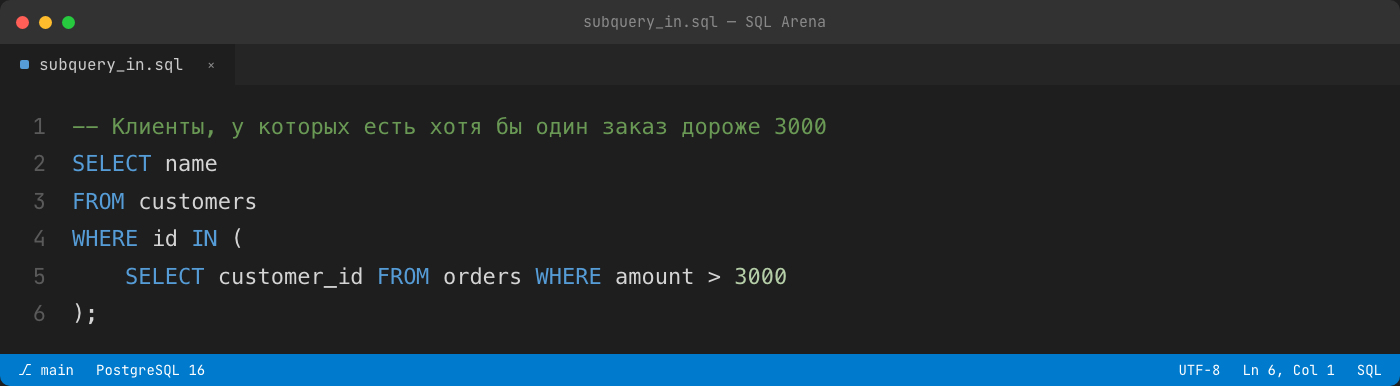
Подзапрос возвращает список customer_id — всех клиентов с заказом дороже 3000. Внешний запрос проверяет, есть ли id клиента в этом списке.
Подзапрос в FROM
Подзапрос может стоять и вместо таблицы — тогда его результат используется как временная таблица для внешнего запроса.
-- Города, где больше одного клиента, с их средним возрастом
SELECT city, customers_count, avg_age
FROM (
SELECT
city,
COUNT(*) AS customers_count,
AVG(age) AS avg_age
FROM customers
GROUP BY city
) city_stats
WHERE customers_count > 1;
Подзапрос в FROM
Подзапрос может стоять и вместо таблицы — тогда его результат используется как временная таблица для внешнего запроса.
-- Города, где больше одного клиента, с их средним возрастом
SELECT city, customers_count, avg_age
FROM (
SELECT
city,
COUNT(*) AS customers_count,
AVG(age) AS avg_age
FROM customers
GROUP BY city
) city_stats
WHERE customers_count > 1;
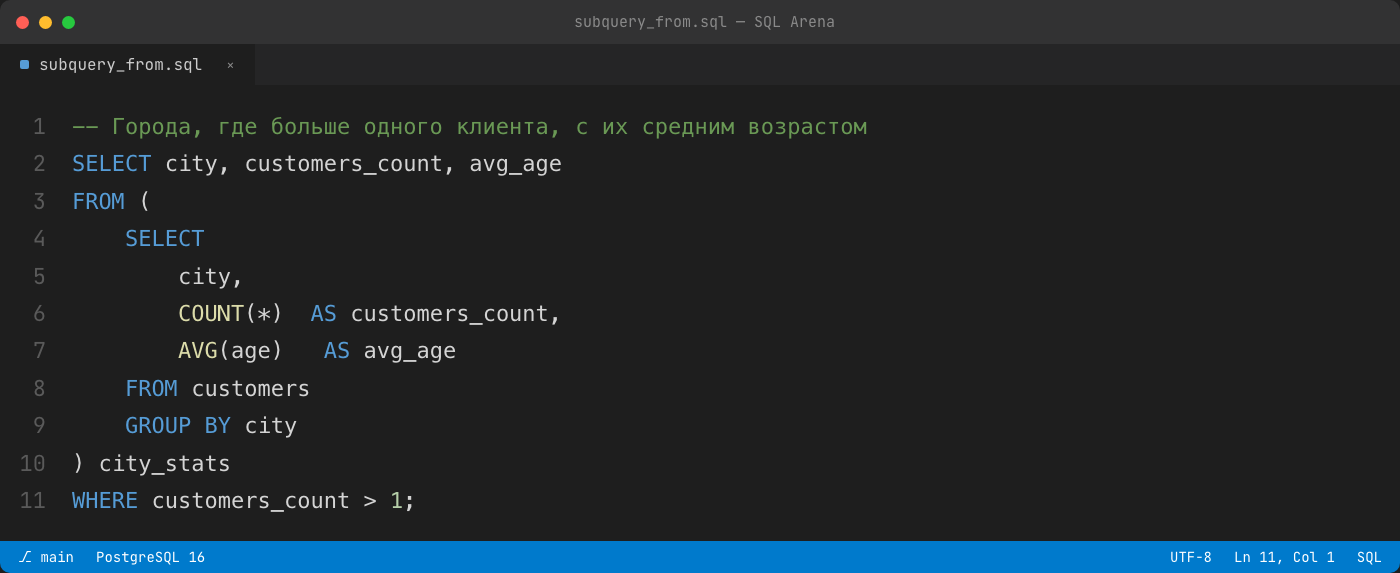
Это решает ту же задачу, для которой в других СУБД или ситуациях используют HAVING — но подзапрос в FROM даёт больше гибкости, когда нужно применить несколько условий или агрегатов к уже посчитанным итогам.
Подзапрос или JOIN: когда что выбрать
Часть задач можно решить и через подзапрос, и через JOIN. Общее правило:
— Нужны колонки из обеих таблиц в результате — берите JOIN. Подзапрос в WHERE возвращает только значение для сравнения, а не колонки второй таблицы.
— Нужно только проверить факт существования («есть ли у клиента заказы», «есть ли клиенты без заказов») — часто чище через подзапрос с EXISTS или IN, чем через JOIN с DISTINCT.
— По скорости — для типовых случаев современные PostgreSQL и MySQL часто приводят эквивалентные подзапрос и JOIN к одному и тому же плану выполнения. На старте выбирайте то, что читается понятнее.
— Нужны колонки из обеих таблиц в результате — берите JOIN. Подзапрос в WHERE возвращает только значение для сравнения, а не колонки второй таблицы.
— Нужно только проверить факт существования («есть ли у клиента заказы», «есть ли клиенты без заказов») — часто чище через подзапрос с EXISTS или IN, чем через JOIN с DISTINCT.
— По скорости — для типовых случаев современные PostgreSQL и MySQL часто приводят эквивалентные подзапрос и JOIN к одному и тому же плану выполнения. На старте выбирайте то, что читается понятнее.
Частые вопросы про агрегаты и подзапросы в SQL
В чём разница между COUNT(*) и COUNT(column)? COUNT(*) считает все строки без исключений. COUNT(column) считает только строки, где значение этой конкретной колонки не NULL. Если в колонке есть пропуски, числа будут разными.
Можно ли использовать агрегатную функцию в WHERE? Нет напрямую — WHERE выполняется до агрегации, значений агрегата на этом этапе ещё не существует. Для фильтрации по агрегату (например, «группы с количеством больше 5») используется HAVING, который применяется уже после GROUP BY.
Что быстрее — подзапрос или JOIN? Чаще всего одинаково: движок баз данных сам оптимизирует запрос и нередко приводит оба варианта к одному плану выполнения. Разница в скорости, если она есть, зависит от конкретных данных и индексов — не стоит выбирать заранее «на глаз».
Что вернёт скалярный подзапрос, если данных нет? Скалярный подзапрос без единой подходящей строки обычно возвращает NULL, а не ошибку. Например, (SELECT AVG(amount) FROM orders WHERE customer_id = 999) для несуществующего клиента вернёт NULL, и последующее сравнение с NULL тоже даст NULL (не TRUE).
Можно ли использовать агрегатную функцию в WHERE? Нет напрямую — WHERE выполняется до агрегации, значений агрегата на этом этапе ещё не существует. Для фильтрации по агрегату (например, «группы с количеством больше 5») используется HAVING, который применяется уже после GROUP BY.
Что быстрее — подзапрос или JOIN? Чаще всего одинаково: движок баз данных сам оптимизирует запрос и нередко приводит оба варианта к одному плану выполнения. Разница в скорости, если она есть, зависит от конкретных данных и индексов — не стоит выбирать заранее «на глаз».
Что вернёт скалярный подзапрос, если данных нет? Скалярный подзапрос без единой подходящей строки обычно возвращает NULL, а не ошибку. Например, (SELECT AVG(amount) FROM orders WHERE customer_id = 999) для несуществующего клиента вернёт NULL, и последующее сравнение с NULL тоже даст NULL (не TRUE).
Что дальше
В этой части — агрегаты (COUNT, SUM, AVG, MIN, MAX) и три формы подзапросов (в WHERE, с IN, в FROM). Это уровень уверенного начинающего, который закрывает большинство задач с собеседований на позиции с базовым SQL.
Отработать эти темы на практике можно на тренажёре SQL Arena — там подзапросы и агрегаты разобраны отдельным блоком задач с проверкой решения и AI-ментором, который подскажет, если запрос не сходится.
Следующий логичный шаг — соединения таблиц во всех вариантах. Это отдельная большая тема — часть 3: JOIN в SQL, разбор всех типов соединений.
Отработать эти темы на практике можно на тренажёре SQL Arena — там подзапросы и агрегаты разобраны отдельным блоком задач с проверкой решения и AI-ментором, который подскажет, если запрос не сходится.
Следующий логичный шаг — соединения таблиц во всех вариантах. Это отдельная большая тема — часть 3: JOIN в SQL, разбор всех типов соединений.
-------
Полезные ссылки школы
Сайт Quality Academy:
https://quality-academy.ru/main
Telegram-канал:
https://t.me/quality_academy
YouTube-канал:
https://www.youtube.com/@quality_academy
ВКонтакте:
https://vk.com/quality_academy
Канал отзывов учеников (58+ отзывов):
https://t.me/quality_academy_reviews
Задать вопрос менеджеру:
https://t.me/quality_academy_bot
Тест «Подойдёт ли вам тестирование»:
https://quiz.quality-academy.ru
5000+ вопросов с собесов тестировщика — бот-тренажёр:
https://t.me/quality_academy_interview_bot
3 практические задачи и дорожная карта:
https://t.me/quality_academy_tasks_bot
Бесплатные тренажёры — SQL Arena, Playwright Arena, Python Arena:
SQL Arena · Playwright Arena · Python Arena
https://quality-academy.ru/main
Telegram-канал:
https://t.me/quality_academy
YouTube-канал:
https://www.youtube.com/@quality_academy
ВКонтакте:
https://vk.com/quality_academy
Канал отзывов учеников (58+ отзывов):
https://t.me/quality_academy_reviews
Задать вопрос менеджеру:
https://t.me/quality_academy_bot
Тест «Подойдёт ли вам тестирование»:
https://quiz.quality-academy.ru
5000+ вопросов с собесов тестировщика — бот-тренажёр:
https://t.me/quality_academy_interview_bot
3 практические задачи и дорожная карта:
https://t.me/quality_academy_tasks_bot
Бесплатные тренажёры — SQL Arena, Playwright Arena, Python Arena:
SQL Arena · Playwright Arena · Python Arena