Оконные функции (window functions) одинаково часто нужны и в продакшене, и на собеседовании. На собеседованиях на позиции аналитика, backend и Middle-разработчика задачи на оконные функции встречаются почти всегда: нарастающий итог, топ-N в группе, сравнение с предыдущим периодом. Большинство реальных задач закрывается десятком устойчивых паттернов.
В этой статье разберём механику OVER(), PARTITION BY, ORDER BY и рамки (frame), а затем пройдём 9 практических паттернов с кодом, который работает в PostgreSQL и MySQL 8+. По ходу отметим типичные ошибки, на которых спотыкаются даже опытные разработчики.
Это часть 5, финальная в серии «SQL с нуля» — после основ, агрегатов с подзапросами, JOIN и CASE, дат, BETWEEN и DISTINCT. Читается и отдельно.
Весь синтаксис проверен под PostgreSQL и MySQL 8.0+. Где поведение диалектов расходится — это оговаривается отдельно.
В этой статье разберём механику OVER(), PARTITION BY, ORDER BY и рамки (frame), а затем пройдём 9 практических паттернов с кодом, который работает в PostgreSQL и MySQL 8+. По ходу отметим типичные ошибки, на которых спотыкаются даже опытные разработчики.
Это часть 5, финальная в серии «SQL с нуля» — после основ, агрегатов с подзапросами, JOIN и CASE, дат, BETWEEN и DISTINCT. Читается и отдельно.
Весь синтаксис проверен под PostgreSQL и MySQL 8.0+. Где поведение диалектов расходится — это оговаривается отдельно.
Что такое оконные функции и чем они отличаются от агрегатов
Обычный агрегат с GROUP BY схлопывает группу строк в одну. Если вы сгруппировали продажи по месяцам и взяли SUM(amount), на выходе будет по одной строке на месяц — исходные строки исчезают.
Оконная функция считает то же агрегатное (или специальное) значение, но не схлопывает строки. Каждая исходная строка остаётся на месте, а рядом появляется вычисленное по «окну» значение. Окно — это набор строк, связанных с текущей строкой.
-- GROUP BY: 12 строк на выходе (по числу месяцев)
SELECT month, SUM(amount)
FROM sales
GROUP BY month;
-- Оконная функция: столько строк, сколько было в таблице
SELECT
month,
amount,
SUM(amount) OVER (PARTITION BY month) AS month_total
FROM sales;
Оконная функция считает то же агрегатное (или специальное) значение, но не схлопывает строки. Каждая исходная строка остаётся на месте, а рядом появляется вычисленное по «окну» значение. Окно — это набор строк, связанных с текущей строкой.
-- GROUP BY: 12 строк на выходе (по числу месяцев)
SELECT month, SUM(amount)
FROM sales
GROUP BY month;
-- Оконная функция: столько строк, сколько было в таблице
SELECT
month,
amount,
SUM(amount) OVER (PARTITION BY month) AS month_total
FROM sales;
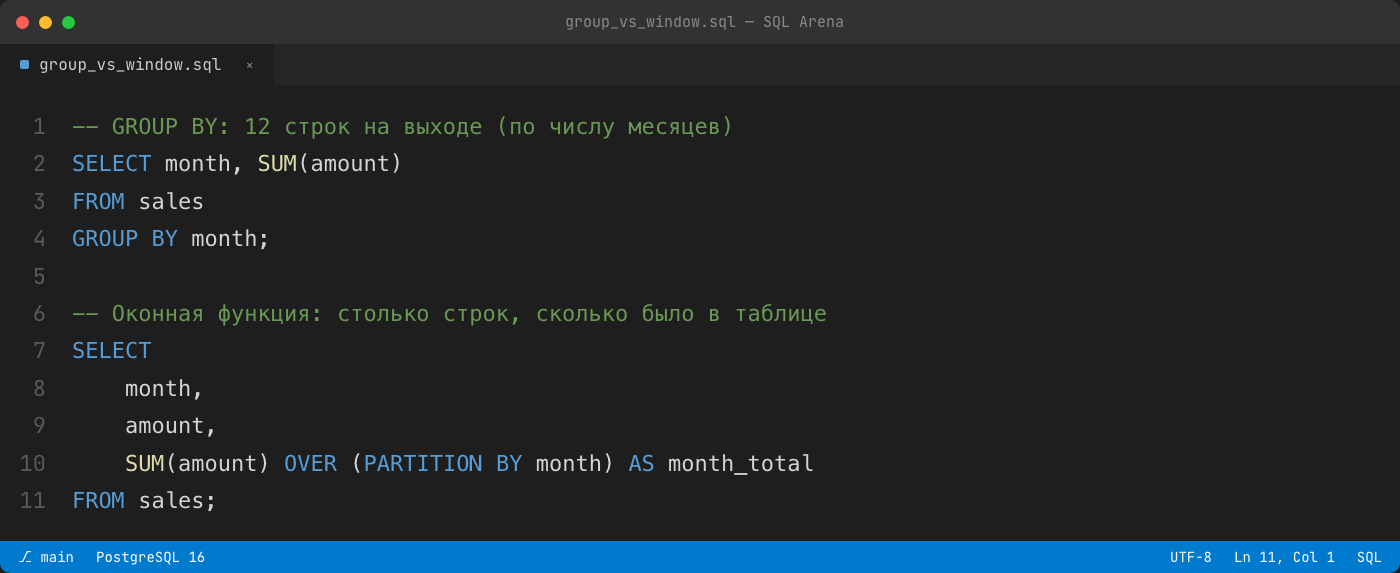
Во втором запросе вы видите и каждую отдельную продажу, и сумму по её месяцу в той же строке. Именно за это оконные функции и ценят.
Анатомия OVER()
Любая оконная функция — это функция() OVER (...). Внутри OVER() три необязательных части:
функция() OVER (
PARTITION BY <колонки> -- на какие группы бьём данные
ORDER BY <колонки> -- порядок внутри группы
<рамка> -- какие строки группы участвуют
)
Анатомия OVER()
Любая оконная функция — это функция() OVER (...). Внутри OVER() три необязательных части:
функция() OVER (
PARTITION BY <колонки> -- на какие группы бьём данные
ORDER BY <колонки> -- порядок внутри группы
<рамка> -- какие строки группы участвуют
)
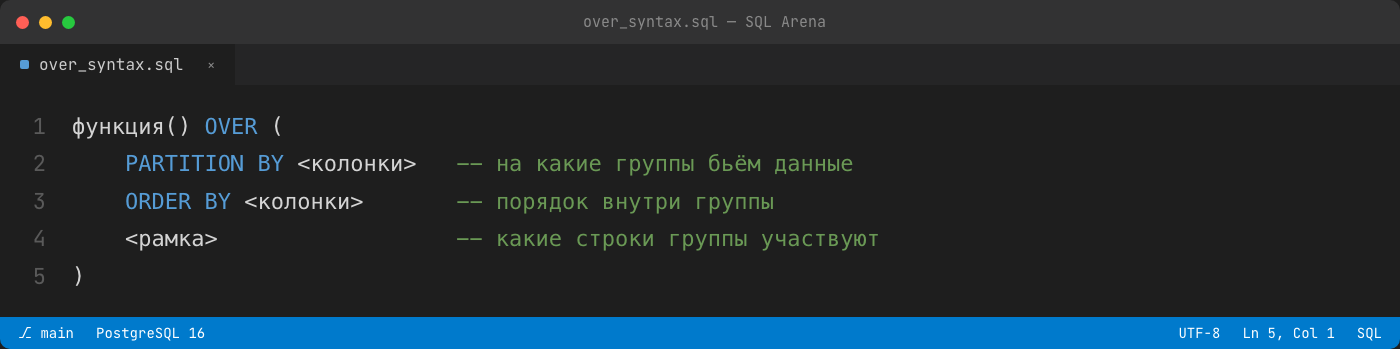
— `PARTITION BY` разбивает строки на независимые секции. Функция считается заново внутри каждой секции. Без PARTITION BY всё множество строк — одна большая секция.
— `ORDER BY` задаёт порядок строк внутри секции. Для ранжирующих функций (ROW_NUMBER, RANK) он обязателен по смыслу. Для агрегатов он включает накопительный режим.
— Рамка (frame) уточняет, какие именно строки секции участвуют в расчёте относительно текущей строки.
Итог: OVER() без единого параметра означает «вся выборка — одна секция целиком».
Рамка: ROWS против RANGE
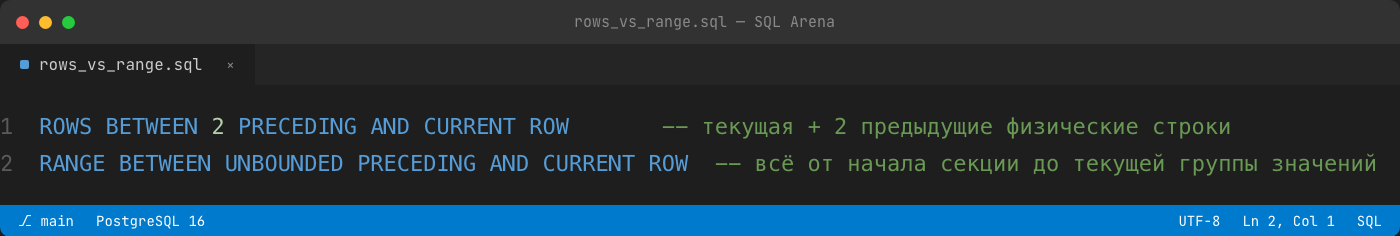
Рамка определяется относительно текущей строки. Два основных режима:
— `ROWS` — отсчёт по физическим строкам: «3 строки назад», «текущая и следующая».
— `RANGE` — отсчёт по значениям в ORDER BY: строки с тем же значением сортировки считаются одной точкой (peer rows, «соседи»).
ROWS BETWEEN 2 PRECEDING AND CURRENT ROW -- текущая + 2 предыдущие физические строки
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW -- всё от начала секции до текущей группы значений
— `ORDER BY` задаёт порядок строк внутри секции. Для ранжирующих функций (ROW_NUMBER, RANK) он обязателен по смыслу. Для агрегатов он включает накопительный режим.
— Рамка (frame) уточняет, какие именно строки секции участвуют в расчёте относительно текущей строки.
Итог: OVER() без единого параметра означает «вся выборка — одна секция целиком».
Рамка: ROWS против RANGE
Рамка определяется относительно текущей строки. Два основных режима:
— `ROWS` — отсчёт по физическим строкам: «3 строки назад», «текущая и следующая».
— `RANGE` — отсчёт по значениям в ORDER BY: строки с тем же значением сортировки считаются одной точкой (peer rows, «соседи»).
ROWS BETWEEN 2 PRECEDING AND CURRENT ROW -- текущая + 2 предыдущие физические строки
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW -- всё от начала секции до текущей группы значений
Важнейший момент про рамку по умолчанию. Если в OVER() есть ORDER BY, но рамка не указана, она автоматически равна:
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
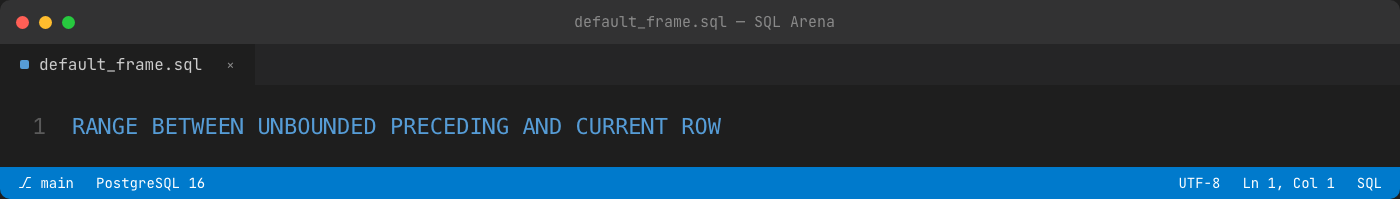
Это означает «от начала секции до текущей строки включительно, но с захватом всех строк-соседей с тем же значением сортировки». Если же ORDER BY нет вообще, рамка охватывает всю секцию целиком. Эта деталь — источник двух классических багов, к которым мы вернёмся в паттернах 4 и 8.
Паттерн 1. Нумерация строк: ROW_NUMBER и разница с RANK / DENSE_RANK
ROW_NUMBER, RANK и DENSE_RANK — три ранжирующие оконные функции, которые присваивают каждой строке номер по заданному порядку. Выглядят похоже, но ведут себя по-разному при равных значениях (ties).
SELECT
name,
score,
ROW_NUMBER() OVER (ORDER BY score DESC) AS rn,
RANK() OVER (ORDER BY score DESC) AS rnk,
DENSE_RANK() OVER (ORDER BY score DESC) AS dense_rnk
FROM players;
SELECT
name,
score,
ROW_NUMBER() OVER (ORDER BY score DESC) AS rn,
RANK() OVER (ORDER BY score DESC) AS rnk,
DENSE_RANK() OVER (ORDER BY score DESC) AS dense_rnk
FROM players;
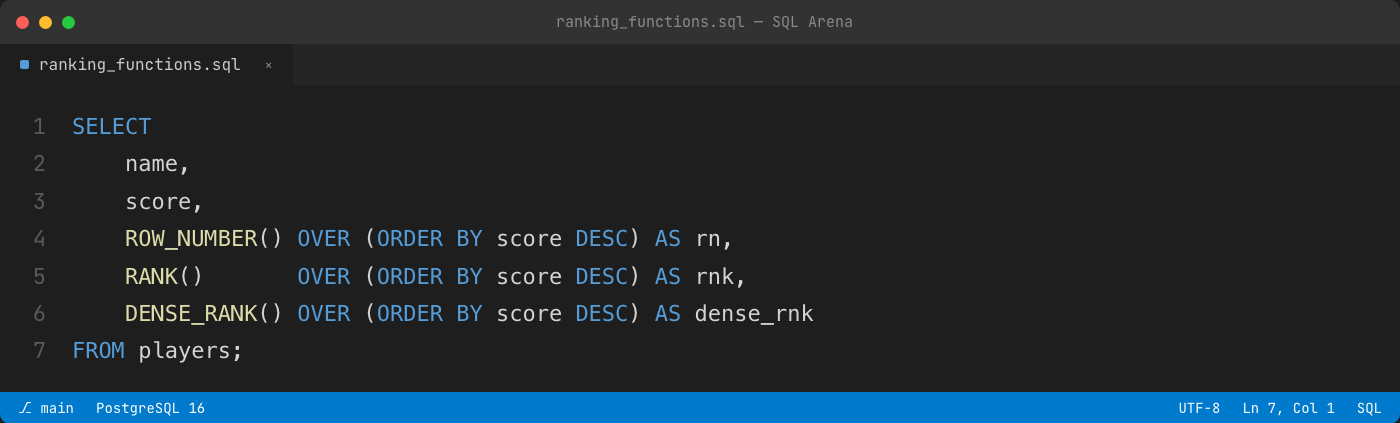
Результат на данных с двумя одинаковыми очками:
— Анна — score: 100, rn: 1, rnk: 1, dense_rnk: 1
— Борис — score: 90, rn: 2, rnk: 2, dense_rnk: 2
— Вера — score: 90, rn: 3, rnk: 2, dense_rnk: 2
— Глеб — score: 80, rn: 4, rnk: 4, dense_rnk: 3
Разница:
— `ROW_NUMBER` даёт уникальный сквозной номер. При равных очках порядок между ними не определён (зависит от внутренней сортировки), поэтому для воспроизводимости в ORDER BY добавляют tie-breaker, например ORDER BY score DESC, id.
— `RANK` присваивает одинаковый ранг равным строкам, но оставляет «дыры»: после двух вторых мест идёт сразу четвёртое.
— `DENSE_RANK` тоже даёт одинаковый ранг равным, но без пропусков: после двух вторых идёт третье.
Запомнить просто: RANK отвечает на вопрос «сколько строк стоит выше плюс один», DENSE_RANK — «сколько различных значений стоит выше плюс один».
— Анна — score: 100, rn: 1, rnk: 1, dense_rnk: 1
— Борис — score: 90, rn: 2, rnk: 2, dense_rnk: 2
— Вера — score: 90, rn: 3, rnk: 2, dense_rnk: 2
— Глеб — score: 80, rn: 4, rnk: 4, dense_rnk: 3
Разница:
— `ROW_NUMBER` даёт уникальный сквозной номер. При равных очках порядок между ними не определён (зависит от внутренней сортировки), поэтому для воспроизводимости в ORDER BY добавляют tie-breaker, например ORDER BY score DESC, id.
— `RANK` присваивает одинаковый ранг равным строкам, но оставляет «дыры»: после двух вторых мест идёт сразу четвёртое.
— `DENSE_RANK` тоже даёт одинаковый ранг равным, но без пропусков: после двух вторых идёт третье.
Запомнить просто: RANK отвечает на вопрос «сколько строк стоит выше плюс один», DENSE_RANK — «сколько различных значений стоит выше плюс один».
Паттерн 2. Топ-N в каждой группе: PARTITION BY + ROW_NUMBER
Классическая задача с собеседований: «выведи по 3 самых дорогих товара в каждой категории». Нумеруем строки внутри каждой группы и фильтруем по номеру.
SELECT category, product, price
FROM (
SELECT
category,
product,
price,
ROW_NUMBER() OVER (
PARTITION BY category
ORDER BY price DESC
) AS rn
FROM products
) t
WHERE rn <= 3;
SELECT category, product, price
FROM (
SELECT
category,
product,
price,
ROW_NUMBER() OVER (
PARTITION BY category
ORDER BY price DESC
) AS rn
FROM products
) t
WHERE rn <= 3;
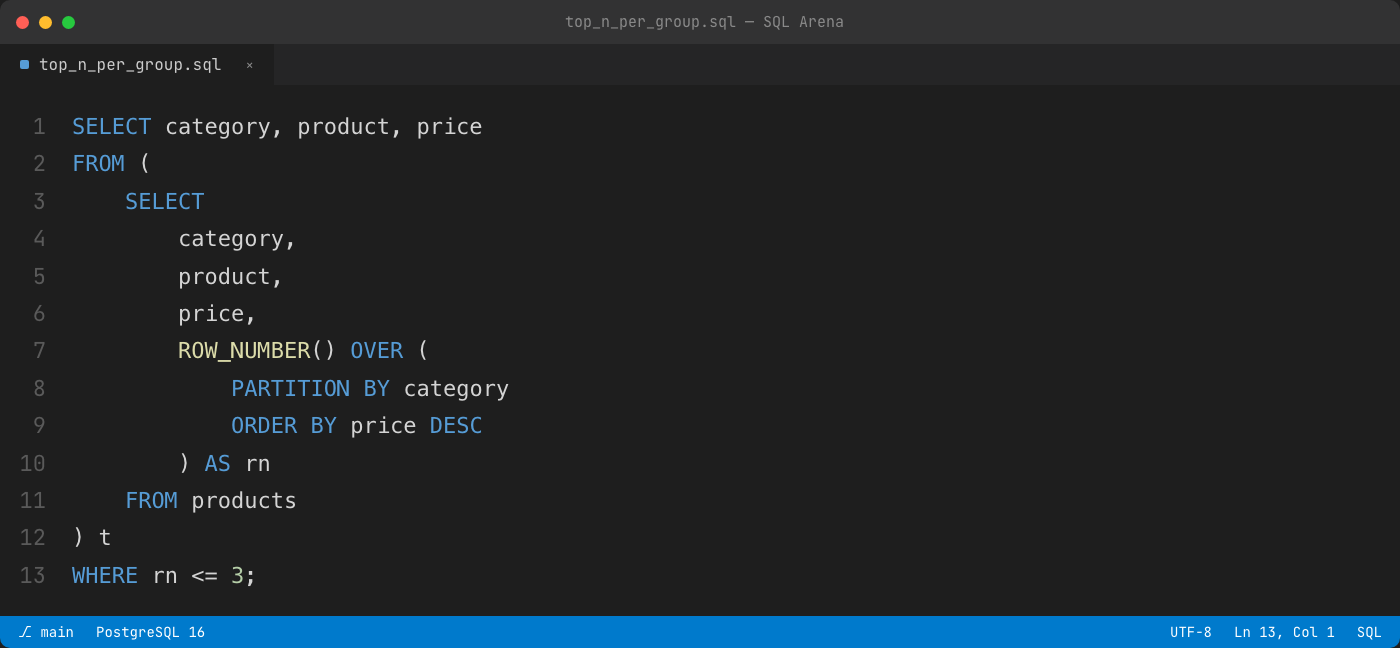
PARTITION BY category перезапускает нумерацию в каждой категории, ORDER BY price DESC сортирует товары по убыванию цены. Дальше остаётся отфильтровать rn <= 3.
Тут всплывает первое фундаментальное ограничение: оконную функцию нельзя использовать прямо в `WHERE`. Оконные функции вычисляются логически после WHERE, GROUP BY и HAVING, поэтому на момент фильтрации значения rn ещё не существует. Решение — обернуть запрос в подзапрос или CTE и фильтровать на внешнем уровне:
WITH ranked AS (
SELECT
category, product, price,
ROW_NUMBER() OVER (PARTITION BY category ORDER BY price DESC) AS rn
FROM products
)
SELECT category, product, price
FROM ranked
WHERE rn <= 3;
Тут всплывает первое фундаментальное ограничение: оконную функцию нельзя использовать прямо в `WHERE`. Оконные функции вычисляются логически после WHERE, GROUP BY и HAVING, поэтому на момент фильтрации значения rn ещё не существует. Решение — обернуть запрос в подзапрос или CTE и фильтровать на внешнем уровне:
WITH ranked AS (
SELECT
category, product, price,
ROW_NUMBER() OVER (PARTITION BY category ORDER BY price DESC) AS rn
FROM products
)
SELECT category, product, price
FROM ranked
WHERE rn <= 3;
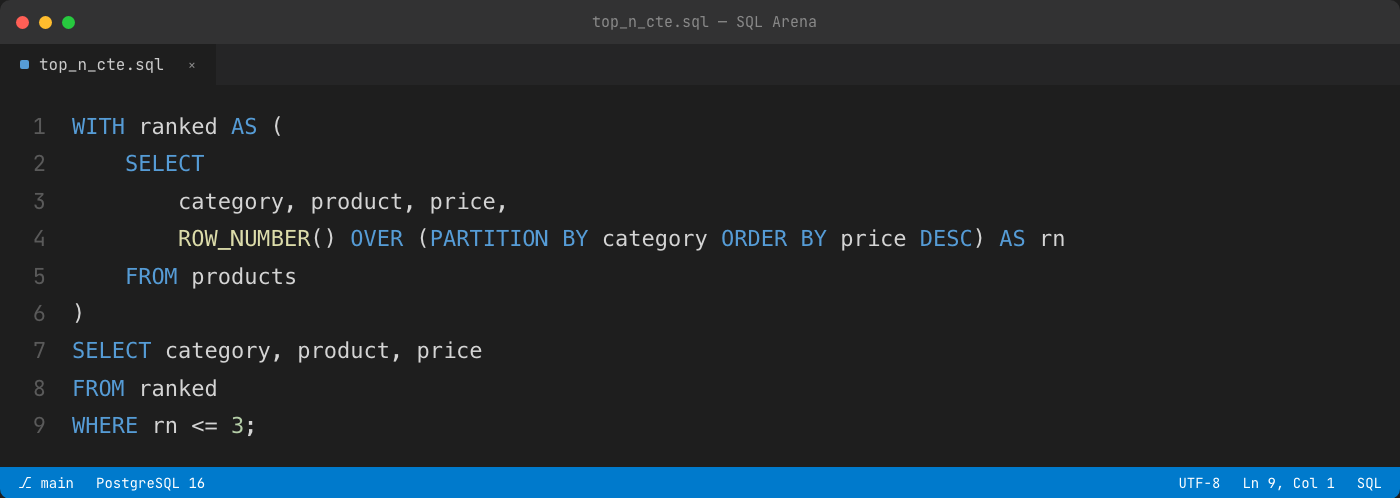
Если в задаче нужно учитывать ничьи (например «топ-3 цены, даже если на третьем месте несколько товаров»), вместо ROW_NUMBER берут RANK или DENSE_RANK.
Паттерн 3. Вторая / N-я по величине через DENSE_RANK
Вопрос «найди вторую по величине зарплату» звучит на собеседованиях постоянно, и почти всегда подразумевает второе уникальное значение, а не вторую строку. Если максимальную зарплату получают трое, второй по величине должна быть следующая другая сумма, а не та же максимальная.
Именно поэтому здесь подходит DENSE_RANK, а не ROW_NUMBER и не RANK:
WITH ranked AS (
SELECT
salary,
DENSE_RANK() OVER (ORDER BY salary DESC) AS dr
FROM employees
)
SELECT DISTINCT salary
FROM ranked
WHERE dr = 2;
Именно поэтому здесь подходит DENSE_RANK, а не ROW_NUMBER и не RANK:
WITH ranked AS (
SELECT
salary,
DENSE_RANK() OVER (ORDER BY salary DESC) AS dr
FROM employees
)
SELECT DISTINCT salary
FROM ranked
WHERE dr = 2;
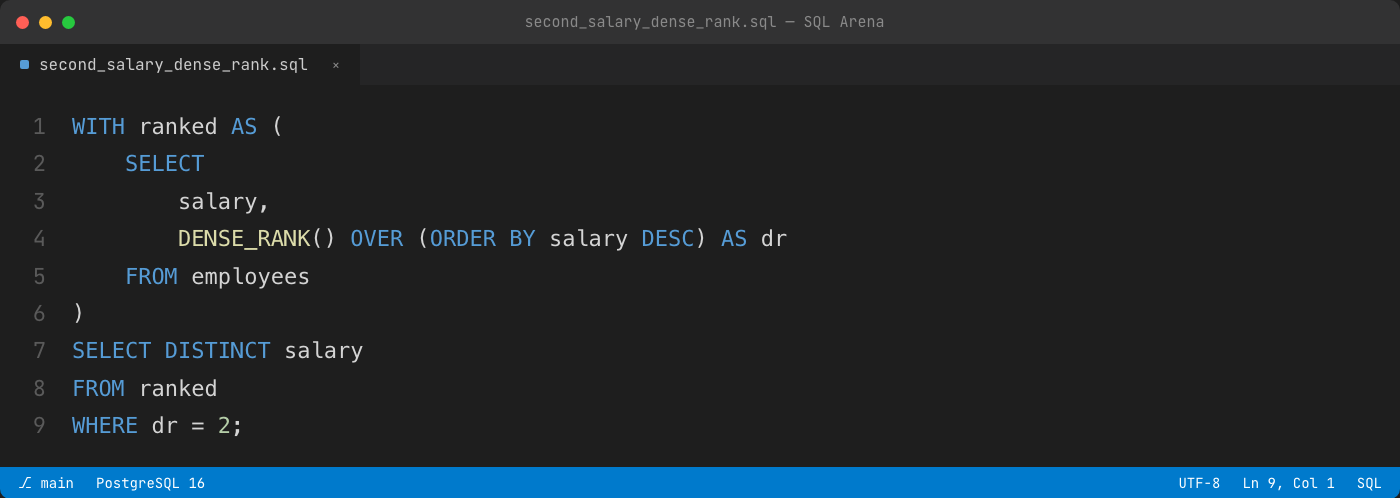
DENSE_RANK нумерует именно различные значения, поэтому dr = 2 всегда указывает на второе уникальное. Чтобы получить N-ю по величине, меняем dr = 2 на нужное число. DISTINCT нужен, поскольку второе значение могло встретиться у нескольких сотрудников.
Если поставить ROW_NUMBER, при дубликатах максимума второй строкой окажется тот же максимум. Если RANK — он пропустит ранг 2, когда максимумов несколько, и WHERE rank = 2 вернёт пусто. Это типичная ловушка.
Если поставить ROW_NUMBER, при дубликатах максимума второй строкой окажется тот же максимум. Если RANK — он пропустит ранг 2, когда максимумов несколько, и WHERE rank = 2 вернёт пусто. Это типичная ловушка.
Паттерн 4. Нарастающий итог (running total): SUM OVER с рамкой
Накопительная сумма — когда каждая строка показывает сумму всех предыдущих плюс себя. Достигается добавлением ORDER BY внутрь OVER():
SELECT
sale_date,
amount,
SUM(amount) OVER (
ORDER BY sale_date
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
) AS running_total
FROM sales;
SELECT
sale_date,
amount,
SUM(amount) OVER (
ORDER BY sale_date
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
) AS running_total
FROM sales;
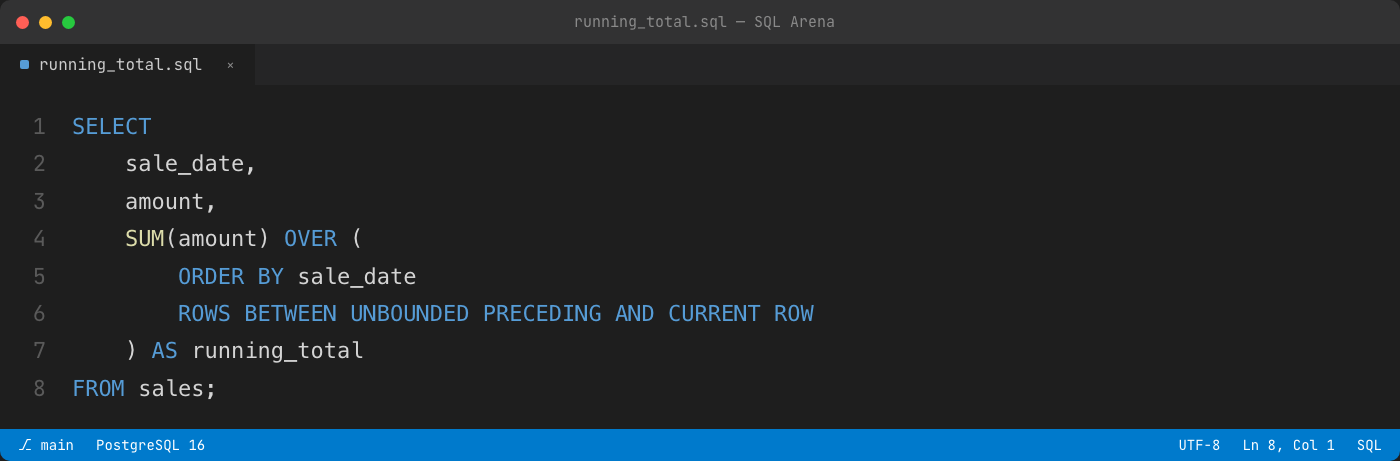
Рамка ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW означает «все строки от начала секции до текущей включительно».
Теперь важная тонкость про рамку по умолчанию. Можно написать короче, без явной рамки:
SUM(amount) OVER (ORDER BY sale_date)
Теперь важная тонкость про рамку по умолчанию. Можно написать короче, без явной рамки:
SUM(amount) OVER (ORDER BY sale_date)
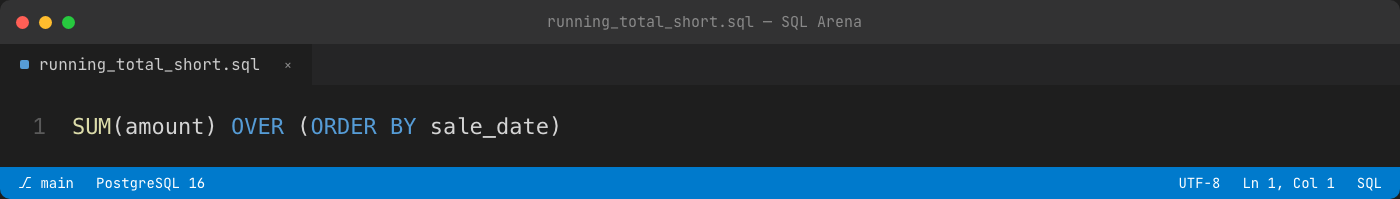
но тогда рамка по умолчанию будет RANGE, а не ROWS. Разница проявляется при дубликатах в `ORDER BY`. Если в один день несколько продаж, RANGE посчитает их как одну точку и для всех строк этого дня вернёт одинаковую сумму — итог на конец дня. ROWS же даст разные значения для каждой строки внутри дня. Для честного построчного накопления используйте явный ROWS.
Для нарастающего итога по группам добавляется PARTITION BY:
SUM(amount) OVER (
PARTITION BY region
ORDER BY sale_date
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
)
Для нарастающего итога по группам добавляется PARTITION BY:
SUM(amount) OVER (
PARTITION BY region
ORDER BY sale_date
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
)
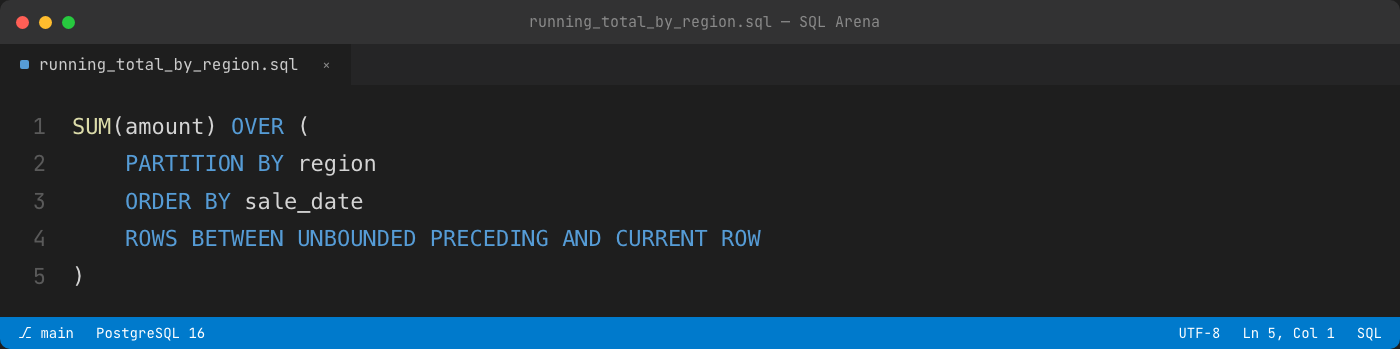
Паттерн 5. Скользящее среднее (moving average): AVG OVER ROWS BETWEEN
Скользящее среднее сглаживает шум во временных рядах. Например, среднее за текущий и два предыдущих дня:
SELECT
sale_date,
amount,
AVG(amount) OVER (
ORDER BY sale_date
ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
) AS moving_avg_3d
FROM sales;
SELECT
sale_date,
amount,
AVG(amount) OVER (
ORDER BY sale_date
ROWS BETWEEN 2 PRECEDING AND CURRENT ROW
) AS moving_avg_3d
FROM sales;
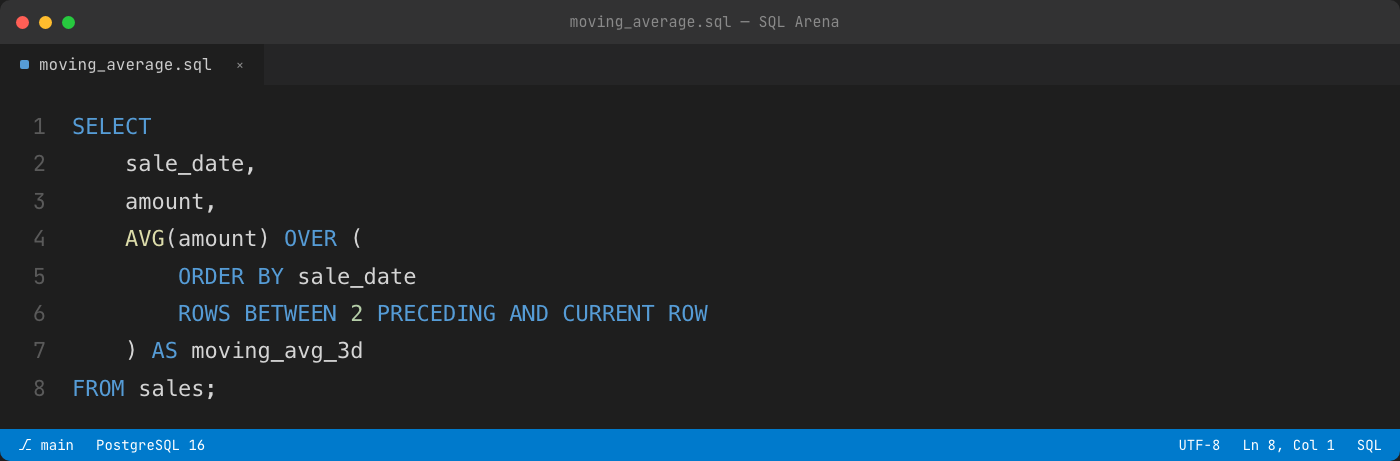
Рамка ROWS BETWEEN 2 PRECEDING AND CURRENT ROW берёт окно из трёх строк: текущую и две до неё. На первых строках секции (когда предыдущих ещё нет) среднее считается по тому, что есть, — это нормальное поведение.
Можно строить и центрированное окно — по строке слева и справа:
AVG(amount) OVER (
ORDER BY sale_date
ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
)
Можно строить и центрированное окно — по строке слева и справа:
AVG(amount) OVER (
ORDER BY sale_date
ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
)
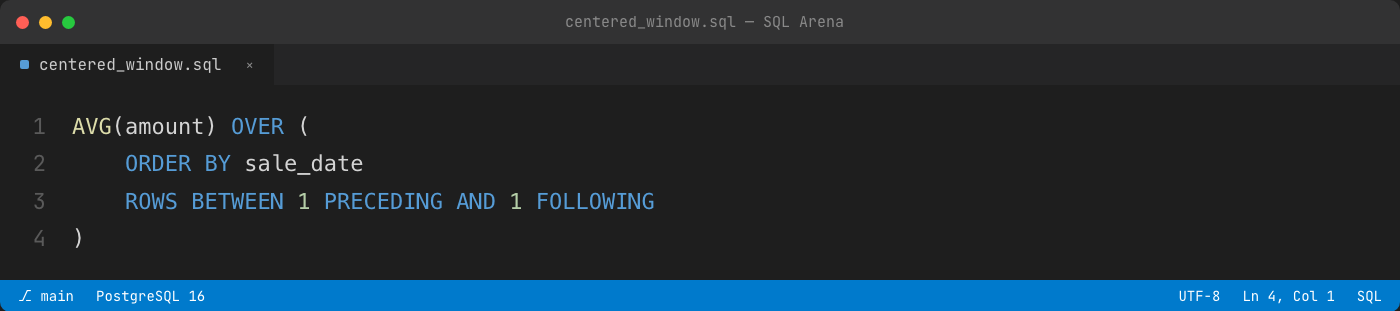
Здесь снова уместен ROWS, а не RANGE: нам нужно именно фиксированное число соседних строк. RANGE BETWEEN 2 PRECEDING означало бы «строки со значением в пределах 2 единиц от текущего», а для дат с интервалами это работает иначе (и в MySQL для RANGE с числовым/интервальным смещением есть свои ограничения по типам). Для скользящих окон по позиции всегда берите ROWS.
Паттерн 6. Сравнение с соседней строкой: LAG и LEAD
LAG достаёт значение из предыдущей строки, LEAD — из следующей. Это основной инструмент для расчёта изменений «месяц к месяцу», «день ко дню».
SELECT
month,
revenue,
LAG(revenue) OVER (ORDER BY month) AS prev_revenue,
revenue - LAG(revenue) OVER (ORDER BY month) AS delta,
ROUND(
(revenue - LAG(revenue) OVER (ORDER BY month))
SELECT
month,
revenue,
LAG(revenue) OVER (ORDER BY month) AS prev_revenue,
revenue - LAG(revenue) OVER (ORDER BY month) AS delta,
ROUND(
(revenue - LAG(revenue) OVER (ORDER BY month))
- 100.0 / LAG(revenue) OVER (ORDER BY month),
- 2
- ) AS growth_pct
- FROM monthly_revenue;
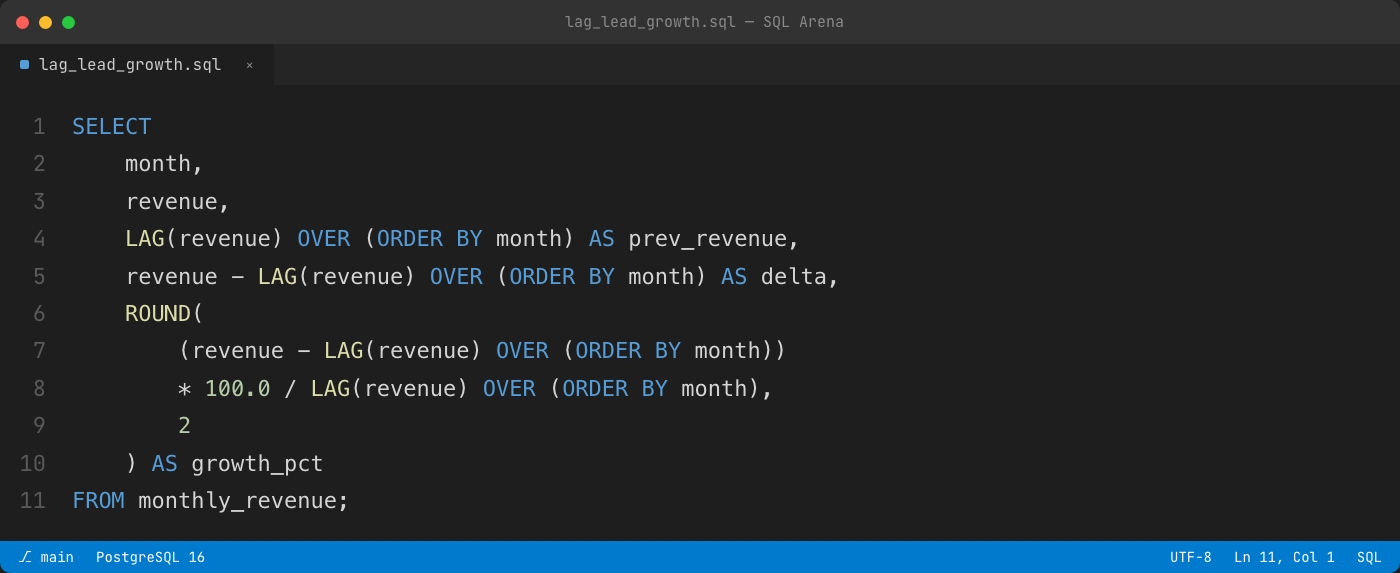
У первой строки предыдущей нет, поэтому LAG вернёт NULL, и delta/growth_pct тоже будут NULL. Это корректно. Если нужно подставить значение вместо NULL, у функций есть параметры смещения и значения по умолчанию:
LAG(revenue, 1, 0) OVER (ORDER BY month)
LAG(revenue, 1, 0) OVER (ORDER BY month)
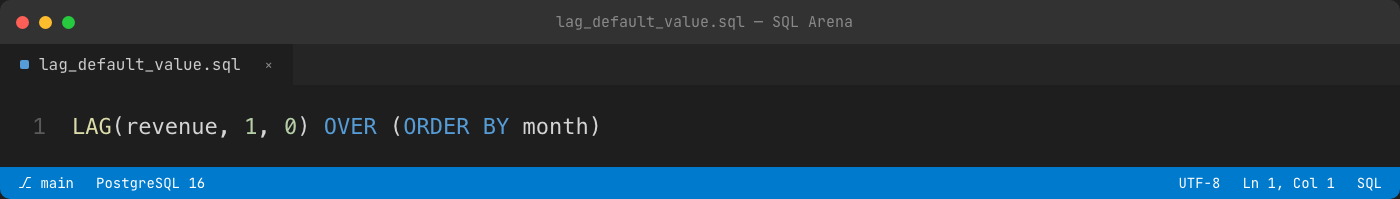
— взять значение на 1 строку назад, а если его нет, вернуть 0. Второй аргумент — это смещение (по умолчанию 1), третий — заполнитель для отсутствующих строк.
LEAD работает симметрично, заглядывая вперёд:
LEAD(revenue) OVER (ORDER BY month) AS next_revenue
LEAD работает симметрично, заглядывая вперёд:
LEAD(revenue) OVER (ORDER BY month) AS next_revenue
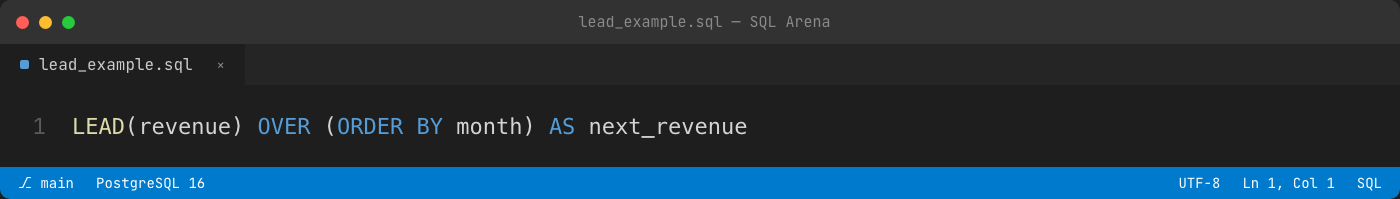
И LAG, и LEAD доступны в PostgreSQL и в MySQL начиная с 8.0.
Паттерн 7. Доля от общего: value / SUM() OVER ()
Чтобы посчитать, какой процент от общей выручки даёт каждая строка, нужна сумма по всему набору рядом с каждой строкой. Здесь пригождается SUM() OVER () с пустым OVER() — без PARTITION BY и ORDER BY это сумма по всей выборке.
SELECT
product,
revenue,
ROUND(
revenue * 100.0 / SUM(revenue) OVER (),
2
) AS pct_of_total
FROM sales;
SELECT
product,
revenue,
ROUND(
revenue * 100.0 / SUM(revenue) OVER (),
2
) AS pct_of_total
FROM sales;
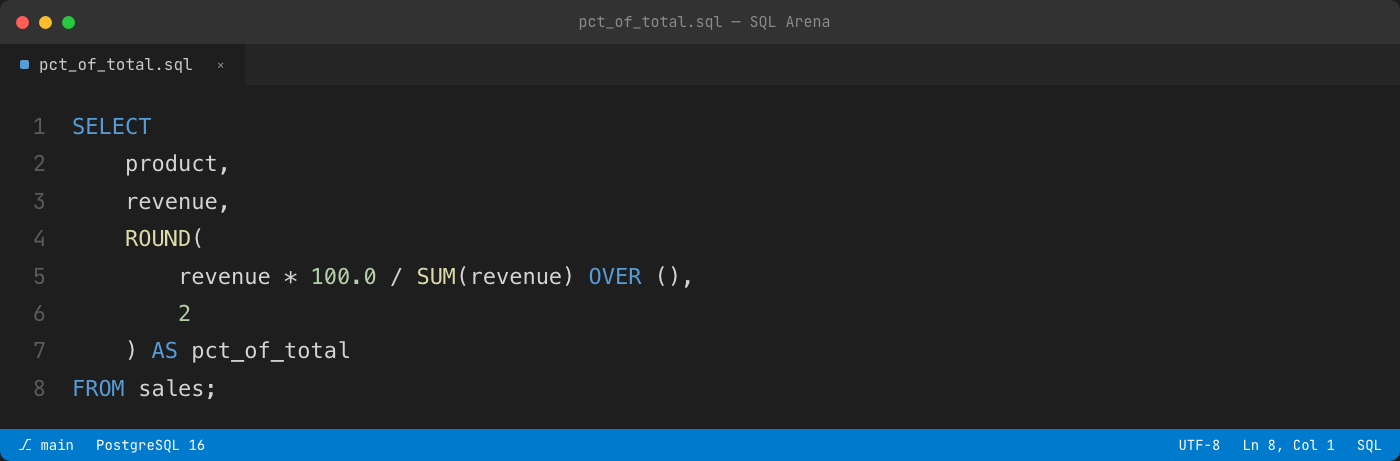
Умножение на 100.0 (а не 100) важно, чтобы избежать целочисленного деления. В PostgreSQL деление двух целых (integer / integer) даёт целое с отбрасыванием дробной части, поэтому revenue * 100 / SUM(...) для долей меньше единицы обнулится — актуально, если колонка типа INTEGER. Если суммы хранятся как NUMERIC/DECIMAL (частый случай для денег), деление и так возвращает дробный результат без 100.0, но привычка ставить .0 в любом случае не помешает и защитит, если тип колонки сменится на целочисленный. В MySQL оператор / всегда возвращает дробный результат независимо от типа, так что там этой ловушки нет, но писать 100.0 стоит для переносимости между диалектами.
Чтобы получить долю внутри группы (например долю товара внутри своей категории), добавляем PARTITION BY:
SELECT
category,
product,
revenue,
ROUND(
revenue * 100.0 / SUM(revenue) OVER (PARTITION BY category),
2
) AS pct_in_category
FROM sales;
Чтобы получить долю внутри группы (например долю товара внутри своей категории), добавляем PARTITION BY:
SELECT
category,
product,
revenue,
ROUND(
revenue * 100.0 / SUM(revenue) OVER (PARTITION BY category),
2
) AS pct_in_category
FROM sales;
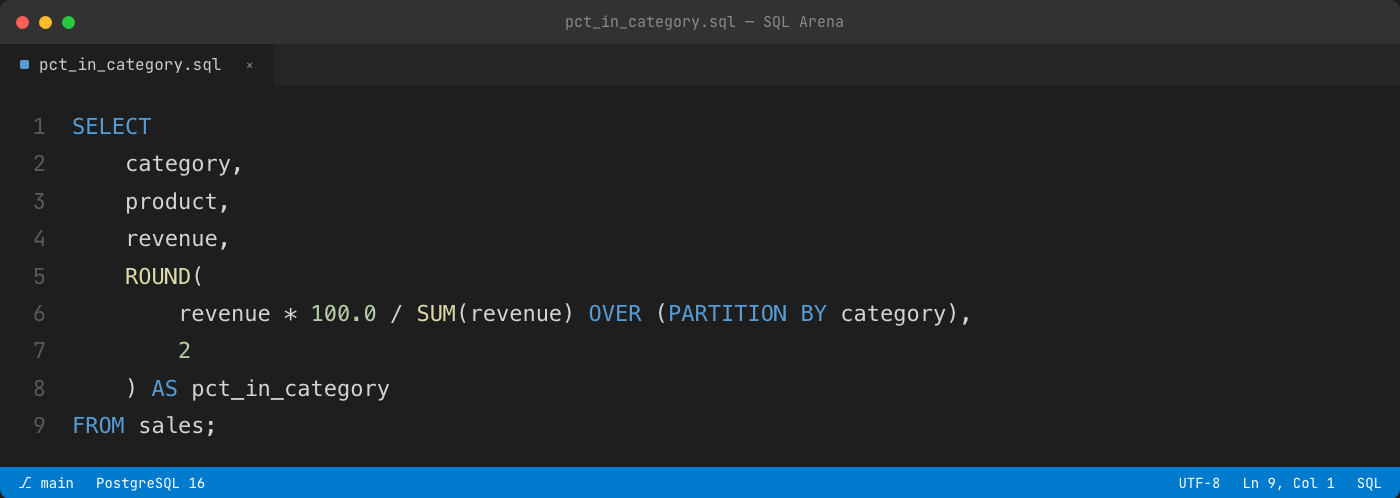
Это очень частый паттерн в продуктовой аналитике: вклад каждого товара, региона или канала в общий результат.
Паттерн 8. Первое и последнее значение в группе: FIRST_VALUE и LAST_VALUE
FIRST_VALUE и LAST_VALUE возвращают первое и последнее значение в рамке. Например, для каждой строки показать первую (самую раннюю) цену товара:
SELECT
product,
sale_date,
price,
FIRST_VALUE(price) OVER (
PARTITION BY product
ORDER BY sale_date
) AS first_price
FROM sales;
SELECT
product,
sale_date,
price,
FIRST_VALUE(price) OVER (
PARTITION BY product
ORDER BY sale_date
) AS first_price
FROM sales;
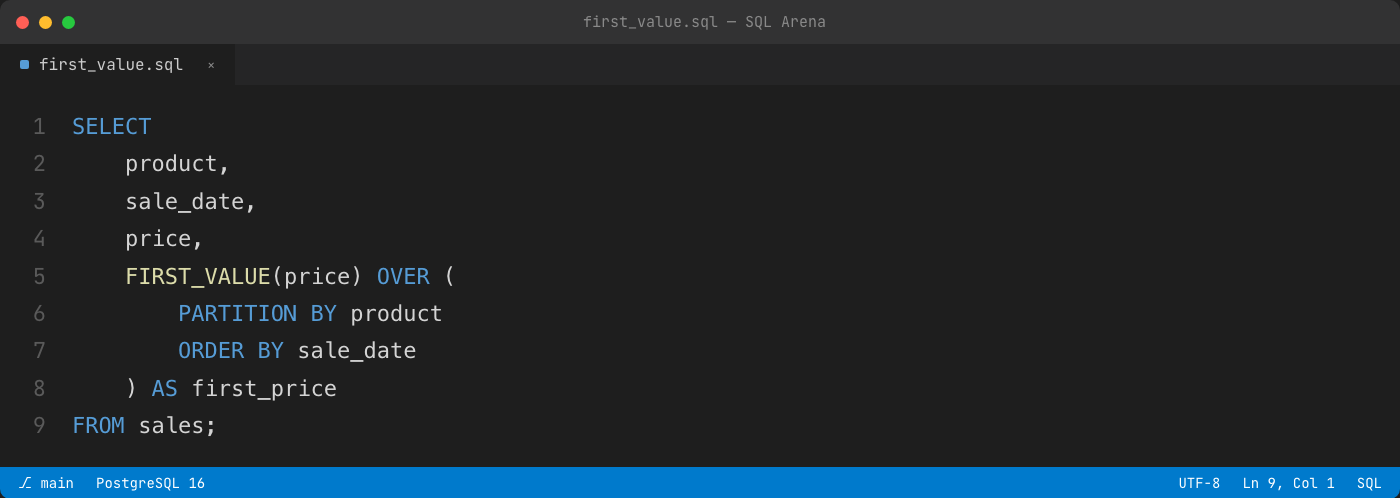
FIRST_VALUE работает корректно даже с рамкой по умолчанию: первая строка секции всегда попадает в окно RANGE UNBOUNDED PRECEDING ... CURRENT ROW.
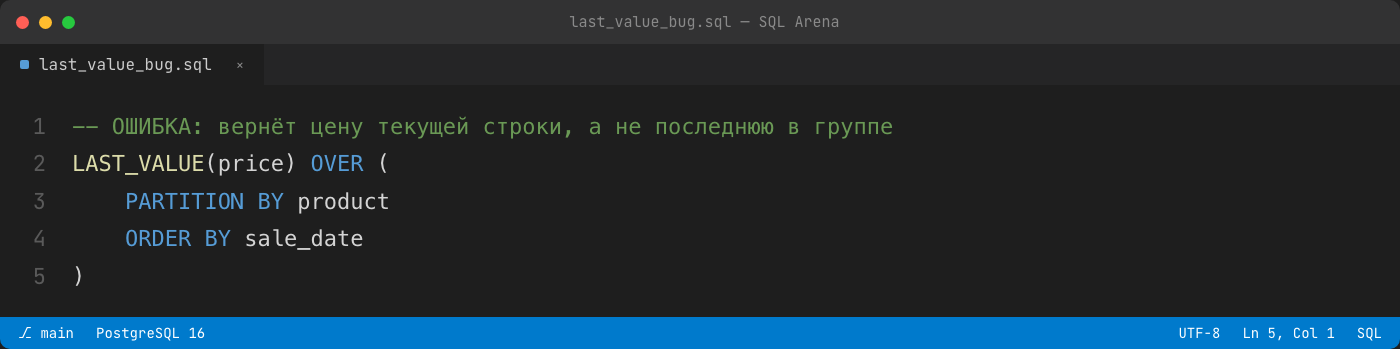
А вот с `LAST_VALUE` кроется самая известная ловушка оконных функций. Интуитивно ждёшь, что LAST_VALUE(price) вернёт последнюю цену в секции. Но из-за рамки по умолчанию (RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) окно заканчивается на текущей строке (точнее — на последней строке среди «соседей» с тем же значением ORDER BY, а не в конце секции). Если значения в ORDER BY не повторяются, это на практике и есть значение текущей строки:
-- ОШИБКА: вернёт цену текущей строки, а не последнюю в группе
LAST_VALUE(price) OVER (
PARTITION BY product
ORDER BY sale_date
)
А вот с `LAST_VALUE` кроется самая известная ловушка оконных функций. Интуитивно ждёшь, что LAST_VALUE(price) вернёт последнюю цену в секции. Но из-за рамки по умолчанию (RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) окно заканчивается на текущей строке (точнее — на последней строке среди «соседей» с тем же значением ORDER BY, а не в конце секции). Если значения в ORDER BY не повторяются, это на практике и есть значение текущей строки:
-- ОШИБКА: вернёт цену текущей строки, а не последнюю в группе
LAST_VALUE(price) OVER (
PARTITION BY product
ORDER BY sale_date
)
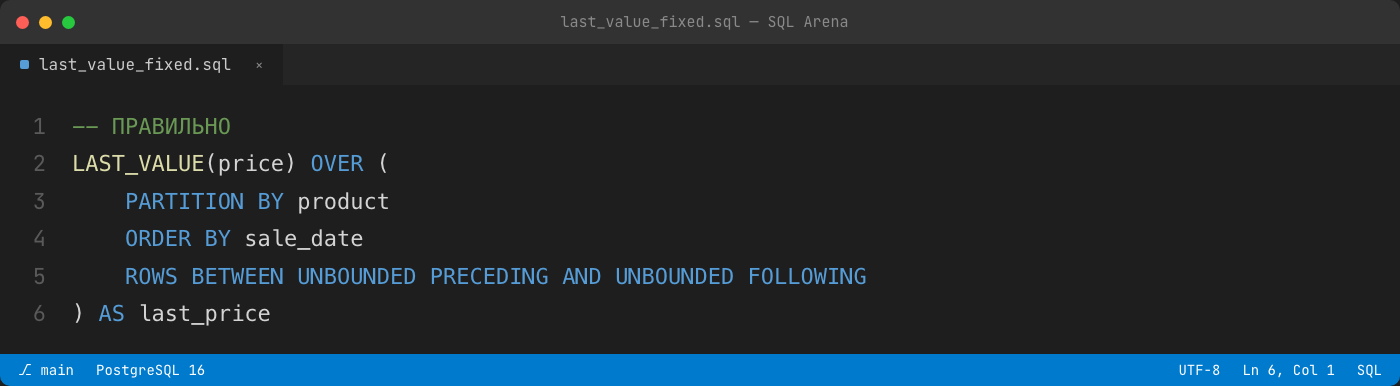
Чтобы LAST_VALUE действительно дал последнее значение секции, нужно явно расширить рамку до конца:
-- ПРАВИЛЬНО
LAST_VALUE(price) OVER (
PARTITION BY product
ORDER BY sale_date
ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
) AS last_price
-- ПРАВИЛЬНО
LAST_VALUE(price) OVER (
PARTITION BY product
ORDER BY sale_date
ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING
) AS last_price
Часто проще обойтись без LAST_VALUE: то же значение даёт FIRST_VALUE с обратной сортировкой (ORDER BY sale_date DESC). Многие разработчики так и поступают, чтобы не помнить про рамку. Это поведение одинаково в PostgreSQL и MySQL 8+ — оно прописано в стандарте SQL, а не является причудой конкретной СУБД.
Паттерн 9. NTILE: деление на квантили и перцентили
NTILE(n) делит строки секции на n примерно равных по размеру групп («бакетов») и возвращает номер группы для каждой строки. Это удобно для квартилей, децилей, перцентильных сегментов.
SELECT
customer,
total_spent,
NTILE(4) OVER (ORDER BY total_spent DESC) AS quartile
FROM customers;
SELECT
customer,
total_spent,
NTILE(4) OVER (ORDER BY total_spent DESC) AS quartile
FROM customers;
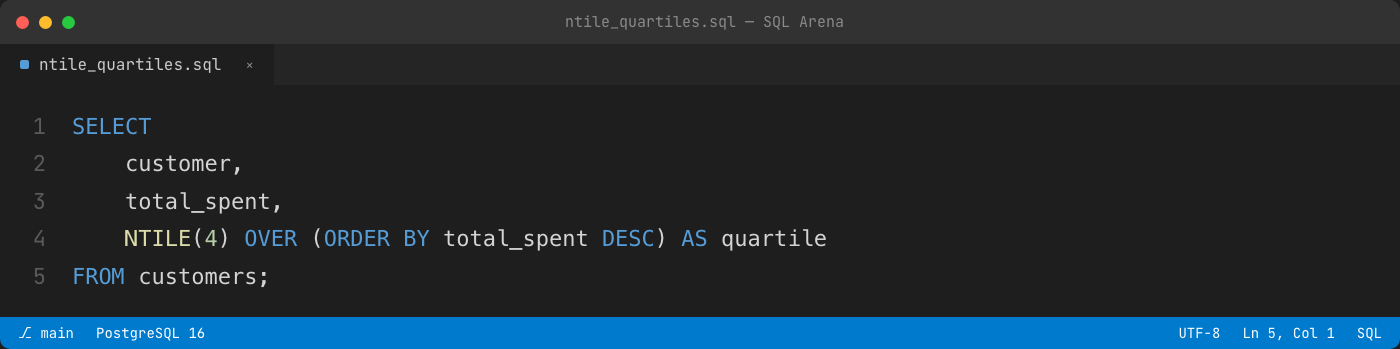
NTILE(4) раскладывает клиентов на 4 квартиля по убыванию трат: в квартиле 1 — самые крупные, в квартиле 4 — самые мелкие. На сегментации клиентов по выручке это базовый приём (RFM-анализ, выделение «топовых» покупателей).
Если число строк не делится на n нацело, первые группы получают на одну строку больше. Например, при 10 строках и NTILE(3) группы будут по 4, 3 и 3 строки. NTILE доступен и в PostgreSQL, и в MySQL 8.0+.
Для непосредственно перцентилей (не группы, а значение на границе) в PostgreSQL есть PERCENTILE_CONT и PERCENTILE_DISC (упорядоченные агрегаты с WITHIN GROUP), но в MySQL 8 их нет — там перцентиль приходится считать через NTILE или ручную арифметику с ROW_NUMBER и COUNT.
Если число строк не делится на n нацело, первые группы получают на одну строку больше. Например, при 10 строках и NTILE(3) группы будут по 4, 3 и 3 строки. NTILE доступен и в PostgreSQL, и в MySQL 8.0+.
Для непосредственно перцентилей (не группы, а значение на границе) в PostgreSQL есть PERCENTILE_CONT и PERCENTILE_DISC (упорядоченные агрегаты с WITHIN GROUP), но в MySQL 8 их нет — там перцентиль приходится считать через NTILE или ручную арифметику с ROW_NUMBER и COUNT.
Сводка типичных ошибок
Чтобы запросы с окнами были не только рабочими, но и верными, держите в голове:
- Оконную функцию нельзя писать в `WHERE`, `HAVING` и `GROUP BY`. Она вычисляется после них. Оборачивайте в подзапрос или CTE и фильтруйте снаружи.
- `LAST_VALUE` без явной рамки `ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING` возвращает значение текущей строки, а не последней в секции.
- Рамка по умолчанию — `RANGE`, а не `ROWS`. При дубликатах в ORDER BY нарастающий итог через RANGE склеит строки-соседи. Для построчного накопления указывайте ROWS явно.
- Не путайте оконный агрегат с обычным. SUM(x) с GROUP BY схлопывает строки, SUM(x) OVER (...) — нет. Смешивать их в одном SELECT без понимания уровня группировки — частая причина неверных чисел.
- `ROW_NUMBER` для «второй по величине» вместо `DENSE_RANK` даст неправильный ответ при дубликатах максимума.
- Целочисленное деление при расчёте долей. Пишите * 100.0, а не * 100.
- `ROW_NUMBER` без tie-breaker не воспроизводим: при равных значениях порядок строк не гарантирован между запусками.
Частые вопросы про оконные функции SQL
Чем ROW_NUMBER отличается от RANK и DENSE_RANK? ROW_NUMBER даёт уникальный сквозной номер каждой строке. RANK присваивает одинаковый ранг равным значениям, но оставляет «дыры» в нумерации после них. DENSE_RANK тоже даёт одинаковый ранг равным значениям, но без пропусков.
Как найти вторую по величине зарплату в SQL? Через DENSE_RANK() OVER (ORDER BY salary DESC) и фильтр WHERE dr = 2 во внешнем запросе или CTE. DENSE_RANK нужен потому, что «вторая по величине» — это второе уникальное значение, а не вторая строка: ROW_NUMBER даст неверный ответ при дублях максимума.
Можно ли использовать оконную функцию в WHERE? Нет. Оконные функции вычисляются логически после WHERE, GROUP BY и HAVING, поэтому на момент фильтрации их результат ещё не существует. Нужно обернуть запрос в подзапрос или CTE и фильтровать на внешнем уровне.
Почему LAST_VALUE возвращает не то значение, что ожидается? Из-за рамки по умолчанию (RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) окно заканчивается на текущей строке, а не на последней в секции. Чтобы получить действительно последнее значение, нужно явно расширить рамку до ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING.
В чём разница между ROWS и RANGE в оконных функциях? ROWS считает физические строки («2 строки назад»). RANGE считает по значениям в ORDER BY — строки с одинаковым значением сортировки трактуются как одна точка. Разница проявляется при дубликатах: для построчного накопления (running total) нужен явный ROWS, иначе RANGE склеит строки-дубликаты в одно значение.
Как найти вторую по величине зарплату в SQL? Через DENSE_RANK() OVER (ORDER BY salary DESC) и фильтр WHERE dr = 2 во внешнем запросе или CTE. DENSE_RANK нужен потому, что «вторая по величине» — это второе уникальное значение, а не вторая строка: ROW_NUMBER даст неверный ответ при дублях максимума.
Можно ли использовать оконную функцию в WHERE? Нет. Оконные функции вычисляются логически после WHERE, GROUP BY и HAVING, поэтому на момент фильтрации их результат ещё не существует. Нужно обернуть запрос в подзапрос или CTE и фильтровать на внешнем уровне.
Почему LAST_VALUE возвращает не то значение, что ожидается? Из-за рамки по умолчанию (RANGE BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW) окно заканчивается на текущей строке, а не на последней в секции. Чтобы получить действительно последнее значение, нужно явно расширить рамку до ROWS BETWEEN UNBOUNDED PRECEDING AND UNBOUNDED FOLLOWING.
В чём разница между ROWS и RANGE в оконных функциях? ROWS считает физические строки («2 строки назад»). RANGE считает по значениям в ORDER BY — строки с одинаковым значением сортировки трактуются как одна точка. Разница проявляется при дубликатах: для построчного накопления (running total) нужен явный ROWS, иначе RANGE склеит строки-дубликаты в одно значение.
Где отработать паттерны на практике
Оконные функции — это навык, который ставится не чтением, а решением задач: пока сам не наступишь на рамку LAST_VALUE или не получишь ноль из-за целочисленного деления, формулировка «знаю синтаксис» остаётся теорией. Отработать каждый из девяти паттернов на живых данных можно на тренажёре SQL Arena от Quality Academy — там есть отдельный блок задач именно на оконные функции, с проверкой результата.
В каталоге более 800 задач, значительная часть доступна бесплатно; часть — по мотивам вопросов с собеседований в Яндекс, Т-Банк, Сбер, Ozon, VK и Авито. У каждой задачи есть AI-ментор, который объясняет, почему запрос не прошёл, и помогает дойти до решения самому. Это полезно как раз на оконных функциях, где ошибка часто не в синтаксисе, а в логике рамки или выборе ранжирующей функции. Решать задачи можно на PostgreSQL, MySQL или ClickHouse — пригодится, если оконные функции вы чаще пишете именно в аналитической СУБД.
В каталоге более 800 задач, значительная часть доступна бесплатно; часть — по мотивам вопросов с собеседований в Яндекс, Т-Банк, Сбер, Ozon, VK и Авито. У каждой задачи есть AI-ментор, который объясняет, почему запрос не прошёл, и помогает дойти до решения самому. Это полезно как раз на оконных функциях, где ошибка часто не в синтаксисе, а в логике рамки или выборе ранжирующей функции. Решать задачи можно на PostgreSQL, MySQL или ClickHouse — пригодится, если оконные функции вы чаще пишете именно в аналитической СУБД.
Итог
Девять паттернов выше покрывают подавляющее большинство задач, которые встречаются в работе аналитика и на собеседованиях:
- ROW_NUMBER / RANK / DENSE_RANK — нумерация и ранжирование. 2. Топ-N в группе — PARTITION BY + ROW_NUMBER + фильтр в CTE. 3. N-я по величине — DENSE_RANK по уникальным значениям. 4. Нарастающий итог — SUM OVER (ORDER BY ... ROWS ...). 5. Скользящее среднее — AVG OVER (... ROWS BETWEEN n PRECEDING ...). 6. LAG / LEAD — сравнение с соседним периодом. 7. Доля от общего — value / SUM() OVER (). 8. FIRST_VALUE / LAST_VALUE — крайние значения секции (помните про рамку). 9. NTILE — деление на квантили.
-------
Полезные ссылки школы
Сайт Quality Academy:
https://quality-academy.ru/main
Telegram-канал:
https://t.me/quality_academy
YouTube-канал:
https://www.youtube.com/@quality_academy
ВКонтакте:
https://vk.com/quality_academy
Канал отзывов учеников (58+ отзывов):
https://t.me/quality_academy_reviews
Задать вопрос менеджеру:
https://t.me/quality_academy_bot
Тест «Подойдёт ли вам тестирование»:
https://quiz.quality-academy.ru
5000+ вопросов с собесов тестировщика — бот-тренажёр:
https://t.me/quality_academy_interview_bot
3 практические задачи и дорожная карта:
https://t.me/quality_academy_tasks_bot
Бесплатные тренажёры — SQL Arena, Playwright Arena, Python Arena:
SQL Arena · Playwright Arena · Python Arena
https://quality-academy.ru/main
Telegram-канал:
https://t.me/quality_academy
YouTube-канал:
https://www.youtube.com/@quality_academy
ВКонтакте:
https://vk.com/quality_academy
Канал отзывов учеников (58+ отзывов):
https://t.me/quality_academy_reviews
Задать вопрос менеджеру:
https://t.me/quality_academy_bot
Тест «Подойдёт ли вам тестирование»:
https://quiz.quality-academy.ru
5000+ вопросов с собесов тестировщика — бот-тренажёр:
https://t.me/quality_academy_interview_bot
3 практические задачи и дорожная карта:
https://t.me/quality_academy_tasks_bot
Бесплатные тренажёры — SQL Arena, Playwright Arena, Python Arena:
SQL Arena · Playwright Arena · Python Arena