JSON-тип данных в реляционной СУБД (JSON/JSONB в PostgreSQL, JSON в MySQL) — это способ хранить полуструктурированные данные (вложенные объекты и массивы произвольной формы) в одной колонке таблицы и обращаться к вложенным полям прямо в SQL-запросе, без ручной сериализации/десериализации на уровне приложения.
Типичный пример — колонка settings с настройками пользователя, metadata с произвольными атрибутами заказа, или payload с сырым ответом внешнего API.
Типичный пример — колонка settings с настройками пользователя, metadata с произвольными атрибутами заказа, или payload с сырым ответом внешнего API.
Как обратиться к полю внутри JSON в PostgreSQL: операторы -> и ->>
SELECT
data -> 'user' ->> 'name' AS user_name,
data -> 'user' ->> 'email' AS user_email
FROM events
WHERE data ->> 'event_type' = 'signup';
data -> 'user' ->> 'name' AS user_name,
data -> 'user' ->> 'email' AS user_email
FROM events
WHERE data ->> 'event_type' = 'signup';
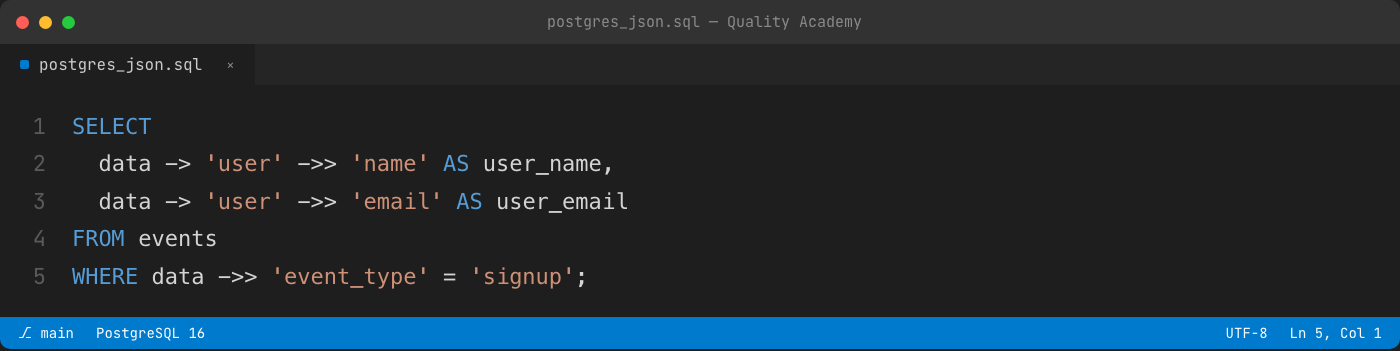
Оператор -> возвращает вложенное значение как JSON (можно продолжать цепочку -> дальше вглубь), а ->> возвращает то же значение как текст (text) — этим оператором цепочку обычно и заканчивают, когда нужно получить конкретное значение для сравнения или вывода. data -> 'user' ->> 'name' сначала берёт JSON-объект по ключу user, потом достаёт из него значение ключа name уже как текст.
JSON и JSONB в PostgreSQL: в чём разница
JSON хранит данные как есть, в виде текста — с сохранением пробелов, порядка ключей и дублирующихся ключей, если они были в исходном JSON. JSONB хранит данные в разобранном бинарном виде: пробелы и порядок вставки не сохраняются, дублирующиеся ключи схлопываются (остаётся последний), но зато JSONB можно индексировать (GIN-индекс) и он быстрее при чтении и операциях сравнения. Запись в JSONB чуть медленнее JSON, потому что PostgreSQL разбирает JSON в бинарный формат сразу при вставке, а не при каждом чтении. Для большинства практических задач (хранение настроек, метаданных, логов, которые потом читают и фильтруют) рекомендуется JSONB, а не JSON — эта рекомендация есть и в официальной документации PostgreSQL.
— Формат хранения. JSON — текст «как есть». JSONB — разобранный бинарный.
— Пробелы и порядок ключей. У JSON сохраняются. У JSONB — не сохраняются.
— Дублирующиеся ключи. У JSON сохраняются все. У JSONB схлопываются (остаётся последний).
— Индекс GIN. У JSON недоступен. У JSONB доступен.
— Скорость чтения/сравнения. JSON медленнее, JSONB быстрее.
— Скорость записи. JSON быстрее, JSONB чуть медленнее (парсинг при вставке).
— Рекомендация PostgreSQL. Для большинства практических задач — JSONB.
— Формат хранения. JSON — текст «как есть». JSONB — разобранный бинарный.
— Пробелы и порядок ключей. У JSON сохраняются. У JSONB — не сохраняются.
— Дублирующиеся ключи. У JSON сохраняются все. У JSONB схлопываются (остаётся последний).
— Индекс GIN. У JSON недоступен. У JSONB доступен.
— Скорость чтения/сравнения. JSON медленнее, JSONB быстрее.
— Скорость записи. JSON быстрее, JSONB чуть медленнее (парсинг при вставке).
— Рекомендация PostgreSQL. Для большинства практических задач — JSONB.
Как ускорить запросы к JSONB: индекс GIN
CREATE INDEX idx_events_data ON events USING GIN (data);
SELECT * FROM events WHERE data @> '{"event_type": "signup"}';
SELECT * FROM events WHERE data @> '{"event_type": "signup"}';
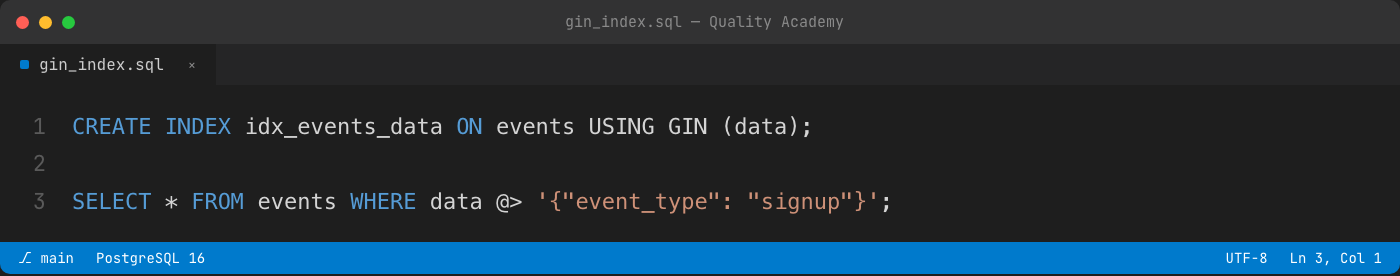
GIN-индекс на JSONB-колонку ускоряет операторы поиска по содержимому (@> — «содержит», ? — «есть ли ключ», и другие операторы containment). Без индекса каждый такой запрос требует разбора JSON в каждой строке таблицы — с ростом таблицы это дорого. Оператор @> в примере проверяет, содержит ли data пару "event_type": "signup" — это отличается от ->>, где нужно точное совпадение по конкретному пути, а @> можно использовать эффективно вместе с GIN-индексом для произвольных полей внутри JSON.
Как обратиться к полю внутри JSON в MySQL: JSON_EXTRACT и ->>
SELECT
JSON_EXTRACT(data, '$.user.name') AS user_name,
data->>'$.user.email' AS user_email
FROM events
WHERE JSON_EXTRACT(data, '$.event_type') = 'signup';
JSON_EXTRACT(data, '$.user.name') AS user_name,
data->>'$.user.email' AS user_email
FROM events
WHERE JSON_EXTRACT(data, '$.event_type') = 'signup';
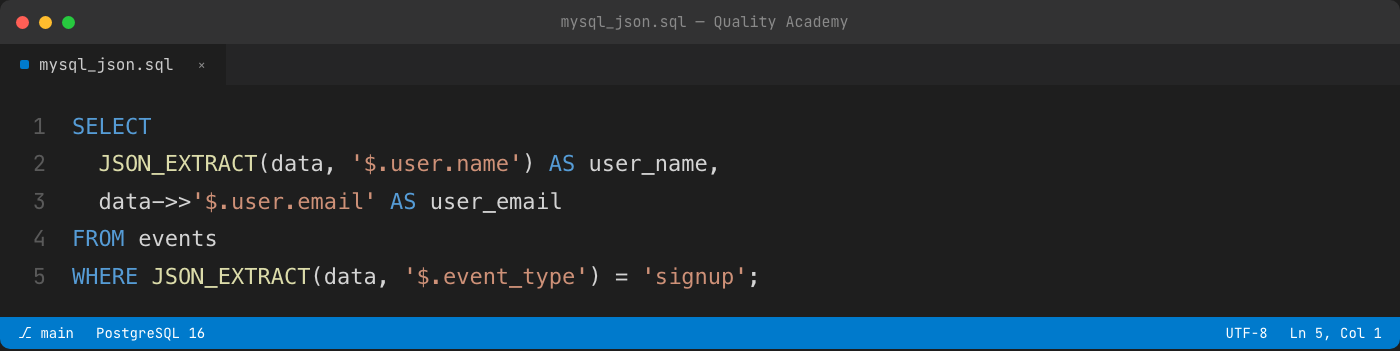
MySQL использует путевые выражения в стиле $.user.name вместо цепочки операторов PostgreSQL. JSON_EXTRACT(data, '$.user.name') возвращает значение по пути как JSON. Начиная с MySQL 5.7.13 доступен укороченный синтаксис data->>'$.user.email' — аналог ->> в PostgreSQL, сразу возвращающий текст без кавычек JSON-строки. Синтаксис пути ($.user.name) в MySQL и синтаксис цепочки операторов (->'user'->>'name') в PostgreSQL — это два принципиально разных подхода к одной задаче, между СУБД он не переносится автоматически.
— Извлечь значение как JSON. PostgreSQL: data -> 'user'. MySQL: JSON_EXTRACT(data, '$.user').
— Извлечь значение как текст. PostgreSQL: data ->> 'user'. MySQL: data->>'$.user' (с версии 5.7.13).
— Синтаксис пути. PostgreSQL — цепочка операторов ->, ->>. MySQL — путевое выражение $.field.subfield.
— Извлечь значение как JSON. PostgreSQL: data -> 'user'. MySQL: JSON_EXTRACT(data, '$.user').
— Извлечь значение как текст. PostgreSQL: data ->> 'user'. MySQL: data->>'$.user' (с версии 5.7.13).
— Синтаксис пути. PostgreSQL — цепочка операторов ->, ->>. MySQL — путевое выражение $.field.subfield.
Когда стоит хранить данные в JSON-колонке, а когда — нет
JSON-колонка удобна для данных с непредсказуемой или часто меняющейся структурой, которые обычно читают целиком или фильтруют по паре полей.
JSON-колонка подходит, когда:
— Структура данных непредсказуемая или часто меняется.
— Данные обычно читают целиком.
— Фильтрация идёт по паре полей, не по всей структуре.
Лучше обычная нормализованная таблица, когда:
— Нужны настоящие внешние ключи и ссылочная целостность на вложенные значения.
— По вложенным полям часто делают JOIN с другими таблицами.
— Нужна строгая валидация типов на уровне базы данных.
— Данные нужно агрегировать (SUM, AVG) по вложенным числовым полям в больших объёмах.
Если нужен хотя бы один из пунктов из второго списка — обычная нормализованная структура таблиц почти всегда работает быстрее и надёжнее, чем JSON-колонка с постоянными извлечениями значений на каждый запрос.
JSON-колонка подходит, когда:
— Структура данных непредсказуемая или часто меняется.
— Данные обычно читают целиком.
— Фильтрация идёт по паре полей, не по всей структуре.
Лучше обычная нормализованная таблица, когда:
— Нужны настоящие внешние ключи и ссылочная целостность на вложенные значения.
— По вложенным полям часто делают JOIN с другими таблицами.
— Нужна строгая валидация типов на уровне базы данных.
— Данные нужно агрегировать (SUM, AVG) по вложенным числовым полям в больших объёмах.
Если нужен хотя бы один из пунктов из второго списка — обычная нормализованная структура таблиц почти всегда работает быстрее и надёжнее, чем JSON-колонка с постоянными извлечениями значений на каждый запрос.
Частые вопросы про JSON в SQL
В чём разница между JSON и JSONB в PostgreSQL? JSON хранит текст как есть (с пробелами, порядком и дубликатами ключей), JSONB — в разобранном бинарном виде (без дублей и порядка вставки), поддерживает индексирование через GIN и быстрее при чтении. Для новых таблиц в PostgreSQL почти всегда стоит выбирать JSONB.
Можно ли делать JOIN по полю внутри JSON? Технически можно, вынеся значение через ->> в подзапросе или CTE и соединяя по нему как по обычному столбцу, но по производительности это заметно хуже обычного JOIN по индексированному столбцу. Если такой JOIN нужен часто — вложенное поле лучше вынести в отдельный обычный столбец.
Нужно ли всегда индексировать JSON/JSONB-колонку? Нет. Индекс (GIN для JSONB) нужен, если по содержимому JSON часто фильтруют или ищут. Если колонку в основном просто читают целиком без фильтрации по вложенным полям, индекс не даст выигрыша, а место на диске и стоимость обновления при записи всё равно возрастут.
MySQL и PostgreSQL используют одинаковый синтаксис работы с JSON? Нет. PostgreSQL использует цепочку операторов (->, ->>, #>, #>>), MySQL — путевые выражения вида $.field.subfield внутри функций (JSON_EXTRACT) или через укороченный оператор ->> с тем же путевым синтаксисом. Прямого переноса запросов между СУБД без переписывания синтаксиса нет.
Можно ли делать JOIN по полю внутри JSON? Технически можно, вынеся значение через ->> в подзапросе или CTE и соединяя по нему как по обычному столбцу, но по производительности это заметно хуже обычного JOIN по индексированному столбцу. Если такой JOIN нужен часто — вложенное поле лучше вынести в отдельный обычный столбец.
Нужно ли всегда индексировать JSON/JSONB-колонку? Нет. Индекс (GIN для JSONB) нужен, если по содержимому JSON часто фильтруют или ищут. Если колонку в основном просто читают целиком без фильтрации по вложенным полям, индекс не даст выигрыша, а место на диске и стоимость обновления при записи всё равно возрастут.
MySQL и PostgreSQL используют одинаковый синтаксис работы с JSON? Нет. PostgreSQL использует цепочку операторов (->, ->>, #>, #>>), MySQL — путевые выражения вида $.field.subfield внутри функций (JSON_EXTRACT) или через укороченный оператор ->> с тем же путевым синтаксисом. Прямого переноса запросов между СУБД без переписывания синтаксиса нет.
Закрепить работу с JSON в SQL на практике
Разница между JSON и JSONB в PostgreSQL или между оператором ->> и путевыми выражениями MySQL перестаёт быть абстракцией, только когда сам пишешь запрос и видишь ошибку синтаксиса. Отработать оба диалекта на реальных задачах — включая индексирование JSONB через GIN и решение, когда JSON стоит развернуть в обычные столбцы, — можно на тренажёре SQL Arena от Quality Academy: диалект переключается одной кнопкой между PostgreSQL и MySQL, а AI-ментор подсказывает, если запрос не сходится. Больше 800 задач, часть — бесплатно.
-------
Полезные ссылки школы
Сайт Quality Academy:
/main
Telegram-канал:
https://t.me/quality_academy
YouTube-канал:
https://www.youtube.com/@quality_academy
ВКонтакте:
https://vk.com/quality_academy
Канал отзывов учеников (58+ отзывов):
https://t.me/quality_academy_reviews
Задать вопрос менеджеру:
https://t.me/quality_academy_bot
Тест «Подойдёт ли вам тестирование»:
https://quiz.quality-academy.ru
5000+ вопросов с собесов тестировщика — бот-тренажёр:
https://t.me/quality_academy_interview_bot
3 практические задачи и дорожная карта:
https://t.me/quality_academy_tasks_bot
Бесплатные тренажёры — SQL Arena, Playwright Arena, Python Arena:
SQL Arena · Playwright Arena · Python Arena
/main
Telegram-канал:
https://t.me/quality_academy
YouTube-канал:
https://www.youtube.com/@quality_academy
ВКонтакте:
https://vk.com/quality_academy
Канал отзывов учеников (58+ отзывов):
https://t.me/quality_academy_reviews
Задать вопрос менеджеру:
https://t.me/quality_academy_bot
Тест «Подойдёт ли вам тестирование»:
https://quiz.quality-academy.ru
5000+ вопросов с собесов тестировщика — бот-тренажёр:
https://t.me/quality_academy_interview_bot
3 практические задачи и дорожная карта:
https://t.me/quality_academy_tasks_bot
Бесплатные тренажёры — SQL Arena, Playwright Arena, Python Arena:
SQL Arena · Playwright Arena · Python Arena